

IP d'inférence à fusion multimodale
FS-FusionCompréhension conjointe vision-langage (VLM) et fusion multi-capteurs, calculées sur place en périphérie.
Pipeline de fusion SmolVLM + SegFormer MiT natif
Détails de FS-FusionFanshi grave les grands modèles de langage directement dans du silicium à calcul en mémoire : trois voies technologiques, une famille de cœurs d'inférence, une seule ligne du modèle au tape-out. Sans réseau, sans donnée qui quitte l'appareil, avec un coût marginal par inférence proche de zéro.
Les mêmes cœurs d'inférence et trois voies technologiques permettent de graver n'importe quel modèle dans une puce. Choisissez celle qui convient, ou faites-en concevoir une autour de votre modèle.
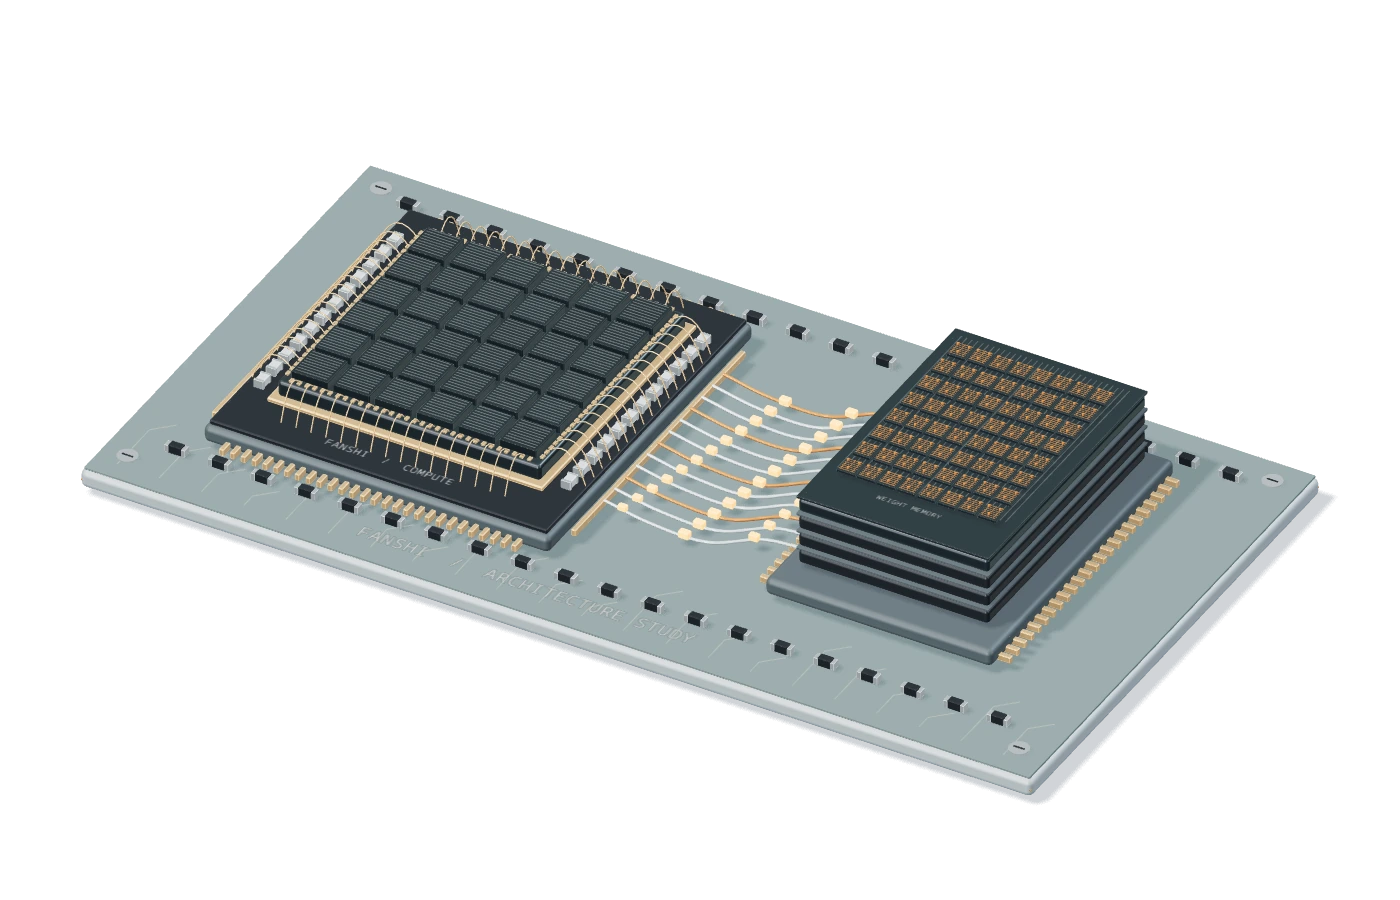
Les GPU et les NPU passent l'essentiel de leur temps et de leur énergie à transporter les poids entre la mémoire et le calcul. Fanshi fait l'inverse : les poids résident dans la matrice mémoire, et le calcul se fait là où ils se trouvent.
Des poids en transit, de l'énergie en transit.
Transfert externe de poids par token
800MB
Origine des transferts
Lectures hors puce · transfert entre puces
0.8B · estimation INT8, hors consommation du systèmeMémoire séparée
Dans un NPU ou un GPU classique, la mémoire et le calcul sont deux morceaux de silicium distincts. Pour chaque token généré, tous les poids traversent le bus : la bande passante fixe le plafond, et l'essentiel de l'énergie se perd en chemin.
Calcul en mémoire
Fanshi intègre les circuits de multiplication-accumulation dans la matrice mémoire elle-même. Les poids restent dans la matrice, les activations entrent, les résultats sortent. Plus aucun poids sur le bus.
MaskROM
Le calcul en mémoire sur ROM à masque inscrit physiquement les poids dans la matrice de vias lors du tape-out. La puce sort de l'usine avec le modèle déjà à l'intérieur : la consommation et le coût marginal par inférence tombent au minimum.
Toutes trois déplacent moins les poids, voire plus du tout. Elles diffèrent par l'endroit où résident les poids et par la possibilité de modifier encore le modèle. Chaque puce de série suit une voie ; pour une puce sur mesure, la voie dépend de la fréquence à laquelle votre modèle change.
Vitesse de décodage sur l'appareil
Objectif de conception Forge · Qwen 3.5 0.8B
Consommation du système
Forge, catégorie embarquée légère
Des données restent sur l'appareil
Inférence locale, sans réseau
Coût marginal par inférence
Après l'achat unique de la puce
Choisissez selon la charge : un appareil de poche de la classe du watt, un nœud qui fait tourner des modèles de 35 milliards de paramètres, ou une puce de vision qui suit chaque image. Si aucune ne convient, nous en concevons une autour de votre modèle.

Un modèle de langage complet dans un appareil de poche de la classe du watt.
Applications types
Les chiffres de cette page correspondent aux définitions de produit et aux objectifs de conception actuels. Les spécifications finales, les conditions de test, la disponibilité et les versions livrées sont confirmées dans les documents de projet validés par les deux parties.
Intégrez sous licence les cœurs d'inférence Fanshi à votre propre ASIC ou FPGA. Une famille de cœurs, quatre architectures, d'abord sur une carte d'évaluation.
Compréhension conjointe vision-langage (VLM) et fusion multi-capteurs, calculées sur place en périphérie.
Pipeline de fusion SmolVLM + SegFormer MiT natif
Détails de FS-Fusion
Prise en charge native des modèles de langage à attention hybride, y compris les couches d'attention complète à portes de la famille Qwen3.5.
Qwen3 / 3.5 (0.6B à 9B) et SmolLM2
Détails de FS-Attention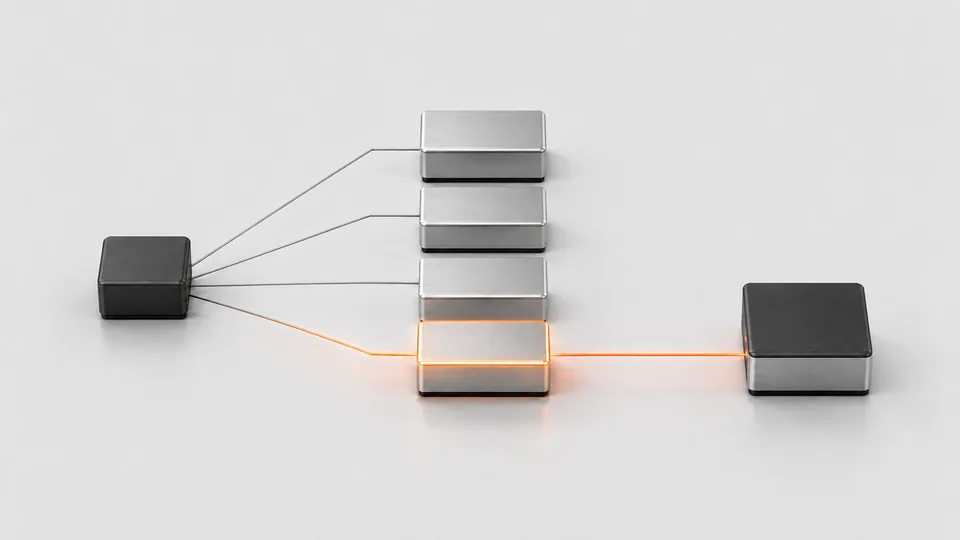
Conçue pour les modèles parcimonieux à activation dynamique : un grand nombre de paramètres dans un budget de bande passante embarqué.
Grands modèles parcimonieux dans un budget embarqué
Détails de FS-MoE
Attention linéaire et architectures de type RNN emmenées par DeltaNet, y compris les couches Gated DeltaNet utilisées à partir de Qwen3.5.
Traitement en flux à très faible latence avec un état de taille fixe, quelle que soit la longueur du contexte
Détails de FS-LinearLa carte d'évaluation et une licence IP adaptable valident le mappage du modèle, les interfaces et toute la chaîne système. Un échantillon d'ingénierie existe avant le silicium : les décisions d'intégration et de tape-out reposent sur des mesures.
Se renseigner sur les licences IP
C'est ainsi que les puces de première génération ont été faites, et la vôtre peut suivre le même chemin : d'abord sur une carte d'évaluation, puis le choix entre une puce existante et la vôtre.
01
Choisir la voie
Modèle cible, objectifs de performance et de consommation, fréquence de mise à jour, interfaces. La première question est toujours la même : à quelle fréquence le modèle change-t-il ?
02
Évaluer
Faire tourner le modèle sur la carte d'évaluation, mesurer la précision et le débit, et obtenir un échantillon d'ingénierie fonctionnel avant tout engagement sur le silicium.
03
Intégrer
Interfaces, logiciel système et validation sur le terrain construits autour des résultats d'évaluation, pour transformer l'échantillon en prototype de produit.
04
Livrer l'ASIC
Une fois le modèle figé : une puce de série, ou l'IP intégrée à votre propre silicium.
Le matériel s'achète une fois. La facture de tokens, elle, ne s'arrête jamais. Choisissez le modèle que vous utilisez aujourd'hui et faites glisser le volume quotidien.
GPU cloud auto-hébergé estimé à $0.70 par million de tokens (loyer médian d'un H100 en 2026). Après l'achat unique de la puce, le coût marginal par inférence est ≈ 0.
Coût d'inférence sur trois ans
Rentabilisée dès le premier mois
Prix : tarifs publics API 2026, moyenne entrée:sortie ≈ 1:1. À titre indicatif ; les coûts réels dépendent de l'usage et du devis.