


Перейти к содержимому

Каждому устройству —собственную LLM.

Fanshi «отливает» большие языковые модели прямо в кремнии с вычислениями в памяти: три технологических маршрута, одно семейство ядер инференса, единая линия от модели до тейпаута. Без сети, без выхода данных за пределы устройства, с почти нулевой предельной стоимостью каждого инференса.

От карманных устройств класса 1 Вт
до узлов для моделей 35B.

Те же ядра инференса и три технологических маршрута позволяют «отлить» в чип любую модель. Выберите подходящий чип или закажите разработку под свою модель.

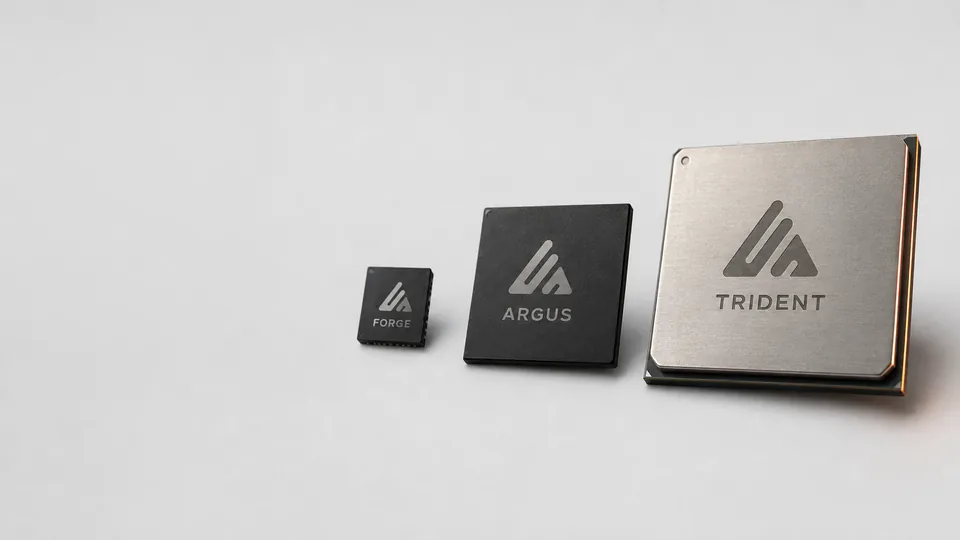
Чипы Fanshi первого поколения для инференса на устройстве — Forge, Argus и Trident — рядом на светло-серой поверхности
Рис. 1 · ASIC первого поколения, слева направо: Forge, Argus, Trident

Вся модель целиком —
в одном чипе.

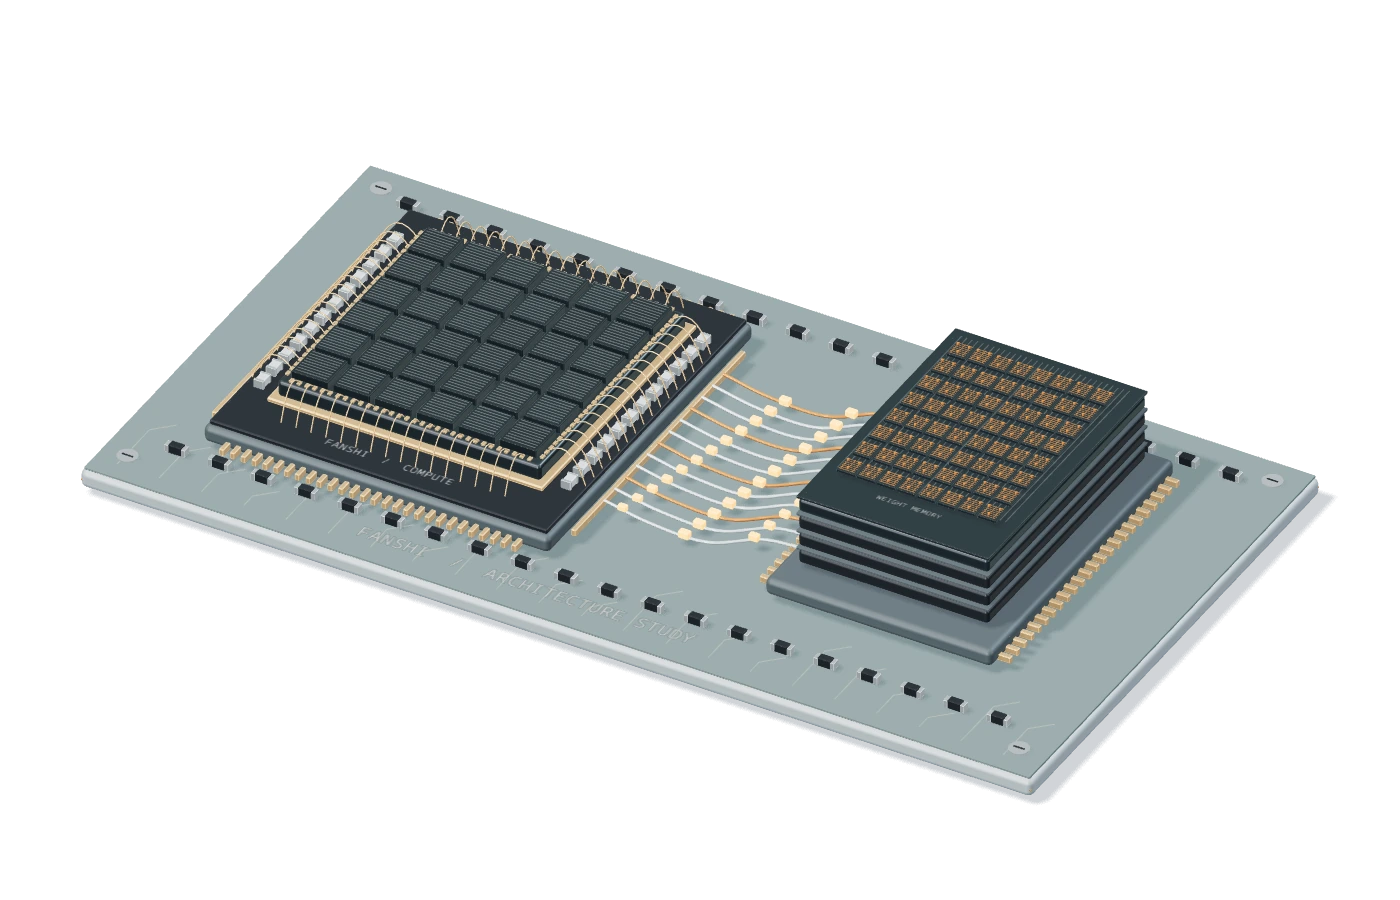
GPU и NPU тратят большую часть времени и энергии на перенос весов между памятью и вычислителем. Fanshi поступает наоборот: веса живут в массиве памяти, а вычисления выполняются там же, где они лежат.

Внутри кремния / ARCHITECTURE STUDY01 / 03

Веса в пути, и энергия в пути.

3D-просмотр

Внешний перенос весов на один токен

800MB

Откуда берётся перенос

Чтение вне кристалла · передача между кристаллами

0.8B · оценка для INT8, не потребление системы
Рис. 2 · Где лежат веса, туда и уходит энергияСхема · не реальная топология
  1. Раздельная память

    Каждый токен перемещает все веса

    В обычном NPU или GPU память и вычислитель — отдельные кристаллы. При генерации каждого токена все веса проходят по шине: пропускная способность задаёт потолок, а большая часть энергии теряется в пути.

  2. Вычисления в памяти

    Поместить веса в массив памяти

    Fanshi встраивает схемы умножения с накоплением прямо в массив памяти. Веса остаются в массиве, активации входят, результаты выходят. Весов на шине больше нет.

  3. MaskROM

    Записано при тейпауте, не перемещается при работе

    Вычисления в памяти на масочном ПЗУ физически записывают веса в массив переходных отверстий при тейпауте. Чип выходит с фабрики уже с моделью внутри, поэтому энергопотребление и предельная стоимость инференса минимальны.

Одна цель,
три маршрута.

Все три переносят веса меньше или не переносят вовсе. Различие в том, где лежат веса и можно ли ещё менять модель. Каждый серийный чип идёт по одному маршруту; для заказного чипа маршрут зависит от того, как часто меняется ваша модель.

17,000token/s

Скорость декодирования на устройстве

Forge, проектная цель · Qwen 3.5 0.8B

~1 Вт

Потребление системы

Forge, лёгкий класс

100%

Данных остаётся на устройстве

Локальный инференс, сеть не нужна

≈ $0

Предельная стоимость инференса

После разовой покупки чипа

ASIC первого поколения:
модель уже внутри.

Выбирайте по нагрузке: карманное устройство класса одного ватта, узел для моделей с 35 миллиардами параметров или чип машинного зрения, успевающий за каждым кадром. Если ни один не подходит, мы создадим чип под вашу модель.

Forge — лёгкий чип для инференса LLM на устройстве, на корпусе лазером нанесён знак Fanshi
Рис. 3 · Forge, лёгкий чип для устройств

Forge

LLM на устройстве

Полноценная языковая модель в карманном устройстве с потреблением около одного ватта.

17,000token/s
Основная модель
Qwen 3.5 0.8B
Скорость декодирования
17 000 токен/с
Потребление системы
Класс 1 Вт
Маршрут
Вычисления в памяти на MaskROM

Типичные применения

  • Карманные переводчики
  • Диктофоны с голосовыми заметками
  • Офлайн-ассистенты в автомобиле
Техническое описание Forge

Показатели на этой странице отражают текущие определения продуктов и проектные цели. Окончательные характеристики, условия испытаний, доступность и версии поставки фиксируются в проектных документах, согласованных обеими сторонами.

Модель ещё меняется?
Не ждите тейпаута.

Лицензируйте ядра инференса Fanshi для собственного ASIC или FPGA. Одно семейство ядер, четыре архитектуры, сначала запуск на оценочной плате.

FS-Fusion: IP инференса с мультимодальным слиянием, иллюстрация
Рис. 7 · FS-Fusion

IP инференса с мультимодальным слиянием

FS-Fusion

Совместное понимание изображения и текста (VLM) и слияние данных нескольких датчиков с вычислениями прямо на устройстве.

Встроенная поддержка конвейера слияния SmolVLM + SegFormer MiT

Подробнее о FS-Fusion

FS-Attention: IP инференса с гибридным вниманием, иллюстрация
Рис. 8 · FS-Attention

IP инференса с гибридным вниманием

FS-Attention

Встроенная поддержка языковых моделей с гибридным вниманием, включая слои полного внимания с вентилями семейства Qwen3.5.

Qwen3 / 3.5 (от 0.6B до 9B) и SmolLM2

Подробнее о FS-Attention
FS-MoE: IP инференса для разреженной смеси экспертов, иллюстрация
Рис. 9 · FS-MoE

IP инференса для разреженной смеси экспертов

FS-MoE

Для разреженных моделей с динамической активацией: большое число параметров в рамках бюджета пропускной способности устройства.

Большие разреженные модели в бюджете устройства

Подробнее о FS-MoE
FS-Linear: IP для линейного внимания и новых архитектур, иллюстрация
Рис. 10 · FS-Linear

IP для линейного внимания и новых архитектур

FS-Linear

Линейное внимание и архитектуры типа RNN во главе с DeltaNet, включая слои Gated DeltaNet, применяемые начиная с Qwen3.5.

Потоковая обработка с очень низкой задержкой и состоянием фиксированного размера при любой длине контекста

Подробнее о FS-Linear

Сначала запуск на FPGA.
Решение о тейпауте потом.

Оценочная плата и настраиваемая лицензия на IP позволяют проверить отображение модели, интерфейсы и весь системный тракт. Инженерный образец появляется раньше кремния, поэтому решения о внедрении и тейпауте опираются на измерения.

Узнать о лицензировании IP
Оценочная плата FPGA на лабораторном столе, подключённая к ноутбуку; в терминале бежит вывод инференса
Рис. 11 · Оценочная плата FPGA с работающим ядром инференса

Любая модель может
пройти эту линию.

Так были сделаны чипы первого поколения, и ваш может пройти тот же путь: сначала запуск на оценочной плате, затем выбор между готовым чипом и собственным.

  1. 01

    Выбор маршрута

    Целевая модель, цели по производительности и потреблению, периодичность обновлений, интерфейсы. Первый вопрос всегда один: как часто меняется модель?

  2. 02

    Оценка

    Запускаем модель на оценочной плате, измеряем точность и пропускную способность и получаем работающий инженерный образец до того, как принято решение о кремнии.

  3. 03

    Внедрение в проект

    Интерфейсы, системное ПО и проверка в реальных условиях на основе результатов оценки: образец становится прототипом продукта.

  4. 04

    Поставка ASIC

    Когда модель зафиксирована: серийный чип или IP, интегрированные в ваш собственный кристалл.

Те же токены.
Разница в 913× за три года.

Оборудование покупают один раз. Счёт за токены не кончается никогда. Выберите модель, которой пользуетесь сейчас, и подвиньте суточный объём.

100K500M
$70$420

Собственный облачный GPU оценён в $0.70 за миллион токенов (медианная аренда H100 в 2026 году). После разовой покупки чипа предельная стоимость инференса ≈ 0.

Стоимость инференса за три года

Окупается в первый же месяц

GPT-5.5 · API$192K
Собственный облачный GPU$7,665
Чип Fanshi$210
API, накопленным итогомСвой GPU, накопленным итогомFanshi, накопленным итогом
0107K215K0 мес.12 мес.24 мес.36 мес.

Цены — усреднённые публичные тарифы API 2026 года (вход:выход ≈ 1:1). Только для иллюстрации; фактические затраты зависят от объёма использования и коммерческого предложения.