

Forge
LLM embarquéPuce embarquée légère
Un modèle de langage complet dans un appareil de poche de la classe du watt.
17,000 token/s
Fig. 2 · Puce embarquée légère
Les ASIC de première génération couvrent les modèles de langage légers, l'inférence à forte charge et la vision multimodale. Les mêmes cœurs et les mêmes voies permettent de concevoir une puce autour de votre modèle.
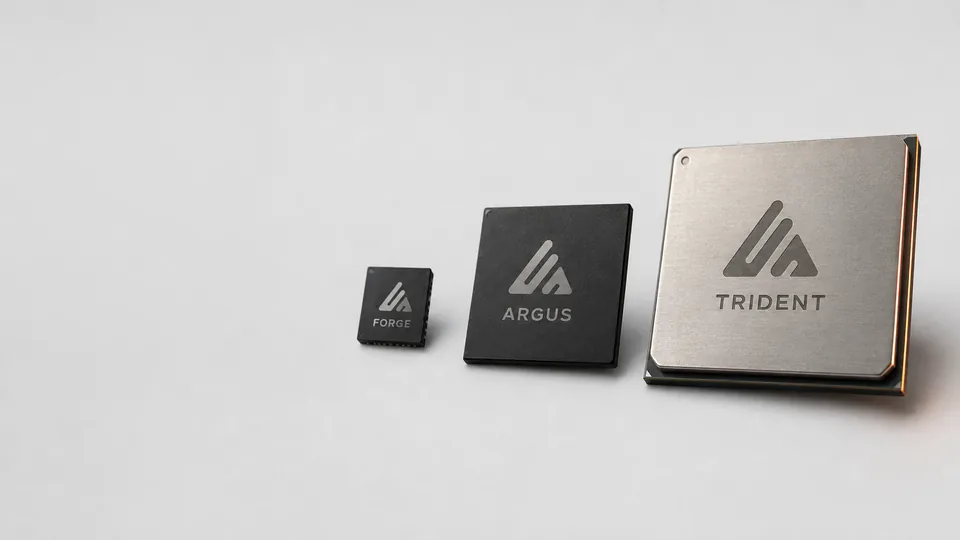
Puce embarquée légère
Un modèle de langage complet dans un appareil de poche de la classe du watt.
17,000 token/s
Fig. 2 · Puce embarquée légère

Puce phare pour fortes charges
Faire tourner un modèle 35B en local à 15 000 token/s, avec un budget système de 70 W.
15,000 token/s
Fig. 3 · Puce phare pour fortes charges

Puce de vision multimodale
Inférence visuelle en temps réel, au pixel près, à 120 FPS.
120 FPS
Fig. 4 · Puce de vision multimodale

Conçue pour votre modèle
Votre modèle, votre puce. Les mêmes cœurs et les mêmes voies, redéfinis autour de votre modèle, de votre budget énergétique et de vos volumes.
0.6B → 35B+ plage de modèles
Fig. 5 · Conçue pour votre modèle
Les chiffres de cette page correspondent aux définitions de produit et aux objectifs de conception actuels. Les spécifications finales, les conditions de test, la disponibilité et les versions livrées sont confirmées dans les documents de projet validés par les deux parties.
Qwen3.5 → 3.6 → 3.8
Qwen3.6 et Qwen3.8 conservent la disposition hybride de Qwen3.5, que les cœurs d'inférence Fanshi mappent déjà. Un modèle plus récent de la même famille est une nouvelle puce, pas une reconception.
01
Choisir la voie
Modèle cible, objectifs de performance et de consommation, fréquence de mise à jour, interfaces. La première question est toujours la même : à quelle fréquence le modèle change-t-il ?
02
Évaluer
Faire tourner le modèle sur la carte d'évaluation, mesurer la précision et le débit, et obtenir un échantillon d'ingénierie fonctionnel avant tout engagement sur le silicium.
03
Intégrer
Interfaces, logiciel système et validation sur le terrain construits autour des résultats d'évaluation, pour transformer l'échantillon en prototype de produit.
04
Livrer l'ASIC
Une fois le modèle figé : une puce de série, ou l'IP intégrée à votre propre silicium.
Le model-on-chip expliqué : ASIC LLM câblés, cloud et embarquéUn ASIC model-on-chip fige les poids d'un seul modèle dans le silicium et gagne plusieurs ordres de grandeur en vitesse. Fonctionnement, ce qu'a montré le Taalas HC1, cloud ou embarqué, questions à poser au fournisseur. Comment choisir une puce d'inférence LLM embarquée : 7 questionsChoisir une puce d'inférence LLM embarquée dépend de l'adéquation au modèle, du budget énergétique et du mode de mise à jour, pas des TOPS de crête. Sept questions et une liste de contrôle.
 Coût d'inférence LLM : API, GPU cloud ou puce embarquée sur 3 ansComptez le coût d'inférence LLM sur trois ans : une API au token, un GPU cloud à l'heure, ou une puce embarquée achetée une fois. Méthode, exemple chiffré et retour sur investissement.
Envoyez le modèle cible, l'objectif de performance, le budget énergétique et les interfaces. Nous confirmons la voie et répondons avec un plan d'évaluation.