

從單瓦級的隨身終端,
到跑 35B 的重載節點。
同一套推理核心、三條存算與近存路線,可以把任何模型固化進矽晶片。現成的選一顆,沒有合適的就為你的模型定製。
把整個大模型,
鑄進一塊晶片。
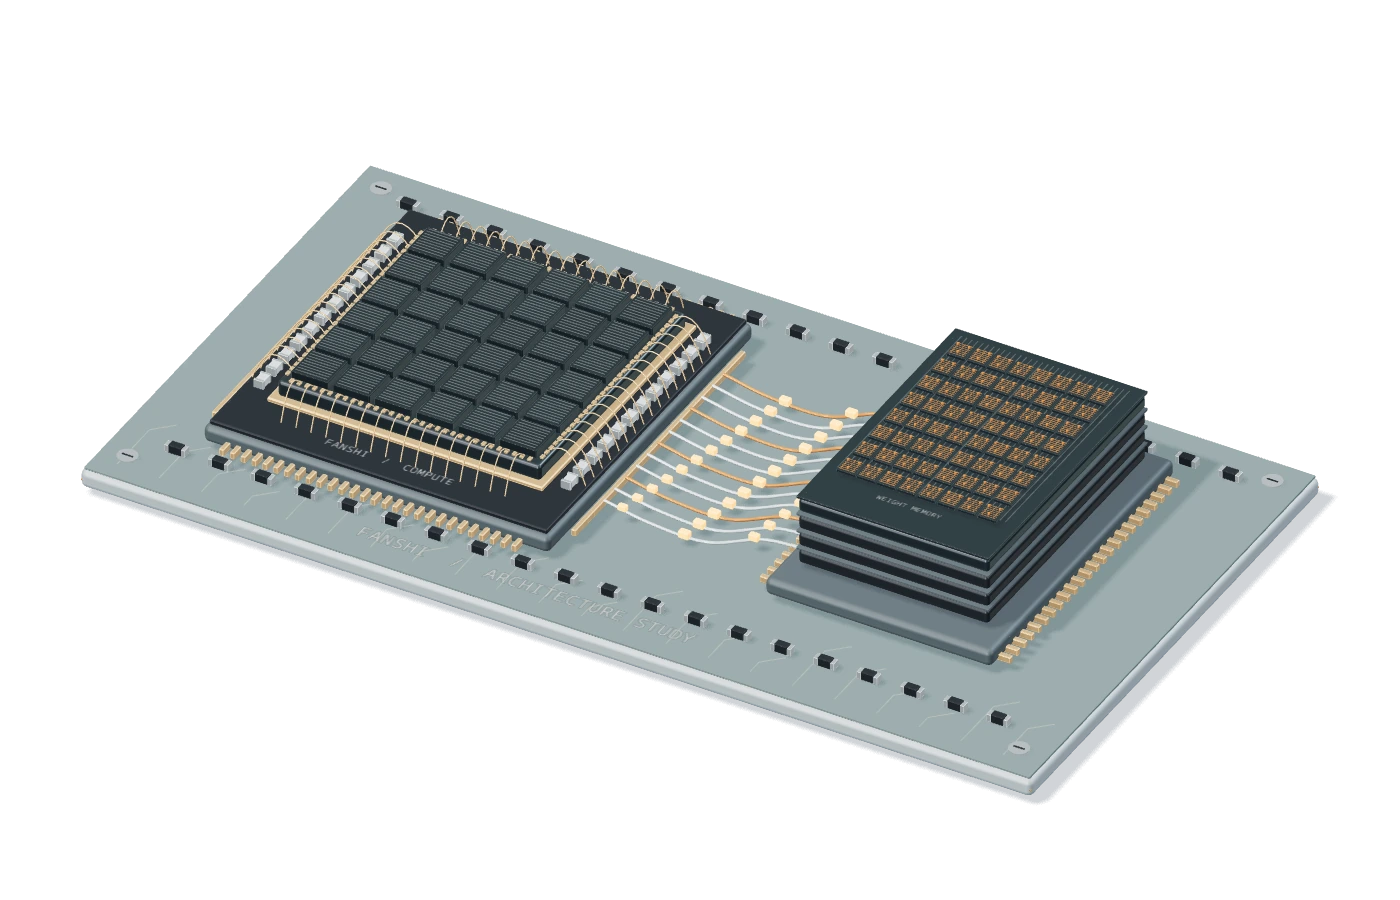
GPU、NPU 把大部分時間和電,花在記憶體與計算單元之間反覆搬運權重。燔石反其道而行:讓權重住在儲存陣列裡,資料在原地完成計算。
矽晶片之內 / ARCHITECTURE STUDY01 / 03
權重在路上,能量也在路上。
三維結構預覽
每 token 外部權重搬運
800MB
搬運開銷來自
外存讀取 · 跨片傳輸
0.8B · INT8 估算,非整機功耗存算分離
權重每個 token 都要搬一遍
傳統 NPU / GPU 裡,儲存和計算是兩塊矽。生成每一個 token,全部權重都要經過匯流排走一遍:頻寬就是上限,能耗大多花在路上。
存算一體
把權重放進儲存陣列
燔石把乘加電路做進儲存陣列旁邊:權重住在陣列裡,激活流過去,結果流出來。匯流排上不再有權重。
MaskROM
投片時鑄進矽晶片,執行時不再搬運
光罩存算一體在投片環節把權重物理寫入通孔陣列。晶片出廠時模型已經在裡面,功耗與單次推理的邊際成本降到最低。
同一個目標,
三條路線。
都是讓權重少搬或不搬。區別在於權重放在哪裡、模型還能不能改。現成晶片各走一條;定製專案按你的模型多久變一次來選。
17,000token/s
端側解碼速度
Forge 設計目標 · Qwen 3.5 0.8B
單瓦級
整機功耗
Forge 端側輕量級
100%
資料不出裝置
本地推理,無需聯網
≈ ¥0
單次推理邊際成本
晶片一次買斷之後
第一代量產 ASIC,
模型出廠就在裡面。
按負載選一顆:單瓦級的隨身終端、跑得動 35B 的重載節點、看得清每一幀的視覺晶片。都不合適,就為你的模型定製一顆。

逐火
Forge把一個完整大模型,裝進單瓦功耗的隨身終端。
17,000token/s
- 核心適配模型
- Qwen 3.5 0.8B
- 解碼速度
- 17,000 token/s
- 整機功耗
- 單瓦級
- 技術路線
- MaskROM 光罩存算一體
頁面參數為當前產品定義與設計目標。最終規格、測試條件、供貨狀態與交付版本以雙方確認的專案資料為準。
模型還在演進,
等不了投片?
把燔石的推理核心授權到你自己的 ASIC 或 FPGA。一套核心,四種結構,先在評估板上跑起來。

混合注意力推理 IP
FS-Attention原生支援混合注意力新結構(Hybrid Attention)的高階大語言模型。
適配 Qwen3 / 3.5(0.6B 至 9B)與 SmolLM2
FS-Attention 詳情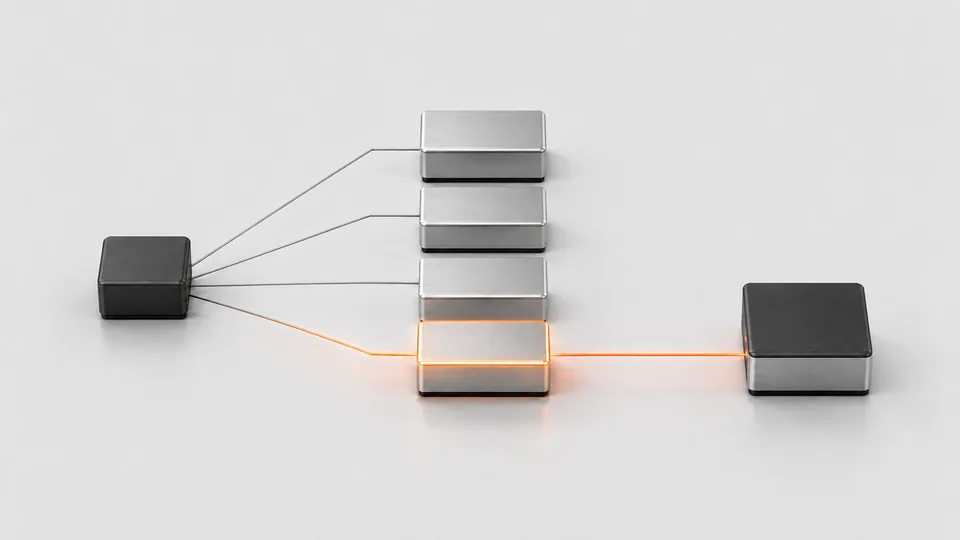

任何模型,
都可以走完這條線。
量產晶片就是從這條線上來的。你的模型也一樣:先在 FPGA 上跑通,再決定用現成晶片還是流一顆自己的。
01
確認路線
目標模型、效能與功耗目標、更新頻率、介面需求。第一個問題永遠是:模型多久變一次。
02
FPGA 評估
在評估板上部署推理核心,跑通模型,測量精度與吞吐,形成第一臺工程樣機。
03
系統匯入
圍繞評估結果做介面、系統軟體與現場驗證,把樣機變成產品原型。
04
ASIC 交付
模型凍結後,採用量產 ASIC,或把 IP 整合進客戶自己的晶片投片。
同樣的 token,
三年賬單差 920×。
硬體是一錘子買賣,token 賬單不是。選一個你正在用的模型,拖一下日均用量。
10 萬5 億
¥500¥3,000
自建雲 GPU 按 ¥5/百萬 token 估算(H100 2026 中位租金)。晶片一次買斷後,單次推理邊際成本≈0。
3 年總推理成本
約第 <1 個月回本
GPT-5.5 · API 呼叫¥138 萬
自建雲 GPU¥5.5 萬
燔石晶片¥1,500
API 累計自建 GPU 累計燔石累計
單價為 2026 年公開 API 價綜合估算(海外按 ¥7.2/$ 折算);測算僅供參考,最終以實際用量與報價為準。