

マルチモーダル融合推論IP
FS-Fusion視覚と言語の統合理解(VLM)とマルチセンサー融合を、エッジのその場で演算します。
SmolVLM + SegFormer MiT の融合パイプラインにネイティブ対応
FS-Fusion の詳細Fanshiは大規模言語モデルをコンピュート・イン・メモリのシリコンに直接焼き込みます。3つの技術ルート、1つの推論コアファミリー、モデルからテープアウトまでの一貫したライン。ネットワーク不要で、データはデバイスの外に出ず、推論1回あたりの限界コストはほぼゼロです。
同じ推論コアと3つの技術ルートで、どんなモデルもチップに焼き込めます。合うものを選ぶか、お客様のモデルに合わせて1つ作るか。
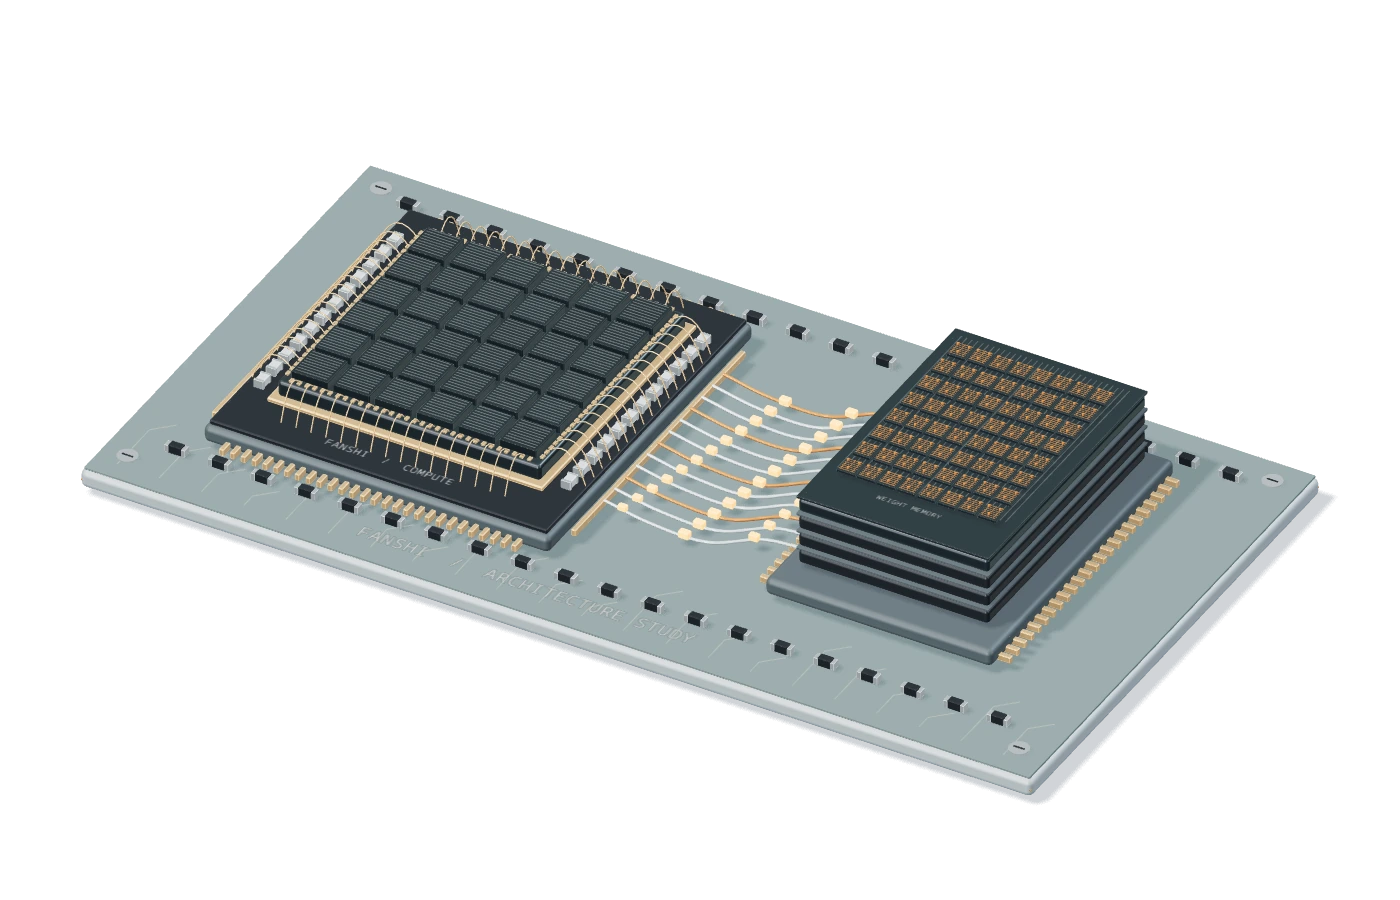
GPUやNPUは、時間と電力の大半を、メモリと演算器のあいだで重みを運ぶことに費やしています。Fanshiはその逆を行きます。重みをメモリアレイに住まわせ、その場で演算します。
重みが移動し、エネルギーも移動する。
トークンあたりの外部重み転送量
800MB
転送が発生する箇所
チップ外の読み出し · チップ間転送
0.8B · INT8 での概算。システム消費電力ではありませんメモリ分離
従来のNPUやGPUでは、メモリと演算器は別々のシリコンです。トークンを1つ生成するたびに、すべての重みがバスを通ります。帯域が上限を決め、エネルギーの大半は移動に消えます。
コンピュート・イン・メモリ
Fanshiは積和演算回路をメモリアレイそのものに組み込みます。重みはアレイにとどまり、活性化が流れ込み、結果が流れ出ます。バスの上に重みはもうありません。
MaskROM
マスクROM方式のコンピュート・イン・メモリは、テープアウト時に重みをビアアレイへ物理的に書き込みます。チップは出荷時点でモデルを内蔵しており、消費電力と推論1回あたりの限界コストは最小になります。
どのルートも、重みの移動を減らすか、なくします。違いは、重みをどこに置くか、モデルをあとから変えられるかです。量産チップはそれぞれ1つのルートを採用しています。カスタムの場合は、モデルの更新頻度に応じてルートを選びます。
デバイス上のデコード速度
Forge 設計目標 · Qwen 3.5 0.8B
システム消費電力
Forge、軽量エッジクラス
データはデバイス内に
ローカル推論、ネットワーク不要
推論1回あたりの限界コスト
チップを一度購入したあと
負荷に合わせて選べます。1ワット級の携帯端末、350億パラメータのモデルを動かすノード、すべてのフレームに追従する視覚チップ。どれも合わなければ、お客様のモデルに合わせて作ります。

1ワット級の携帯端末に、言語モデルをまるごと。
このページの数値は、現時点の製品定義と設計目標です。最終仕様、試験条件、供給状況、納入バージョンは、双方が合意したプロジェクト資料で確定します。
Fanshiの推論コアを、お客様のASICやFPGAにライセンスします。1つのコアファミリーで4つのアーキテクチャに対応。まずは評価ボードで動かせます。
視覚と言語の統合理解(VLM)とマルチセンサー融合を、エッジのその場で演算します。
SmolVLM + SegFormer MiT の融合パイプラインにネイティブ対応
FS-Fusion の詳細
ハイブリッド・アテンションを用いる言語モデルにネイティブ対応。Qwen3.5ファミリーのゲート付きフルアテンション層を含みます。
Qwen3 / 3.5(0.6B から 9B)と SmolLM2
FS-Attention の詳細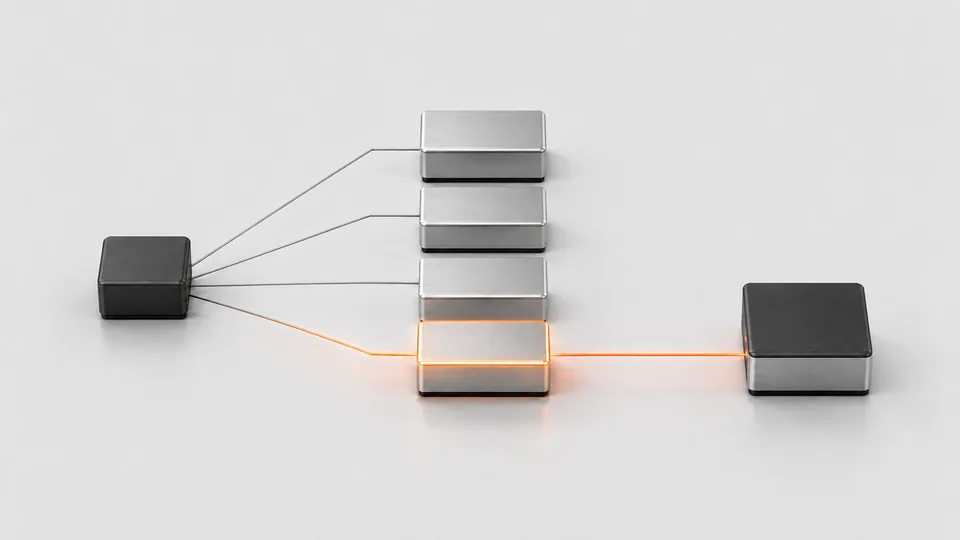
DeltaNetに代表される線形アテンションとRNN系アーキテクチャに対応。Qwen3.5以降で使われる Gated DeltaNet 層を含みます。
コンテキストがどれだけ長くても状態サイズは固定。超低遅延のストリーミング処理
FS-Linear の詳細評価ボードとカスタマイズ可能なIPライセンスで、モデルマッピング、インターフェース、システム全体の経路を検証します。シリコンより先にエンジニアリングサンプルが手に入るため、設計への組み込みとテープアウトを実測にもとづいて判断できます。
IPライセンスについて問い合わせる
第1世代のチップはこうして作られました。お客様のモデルも同じ道をたどれます。まず評価ボードで動かし、そのうえで既存チップを使うか、専用チップを作るかを決めます。
01
ルートを選ぶ
対象モデル、性能と消費電力の目標、更新頻度、インターフェース。最初の問いはいつも同じです。そのモデルはどのくらいの頻度で変わりますか。
02
評価する
評価ボード上でモデルを動かし、精度とスループットを測定します。シリコンを確定する前に、動作するエンジニアリングサンプルが手に入ります。
03
設計に組み込む
評価結果をもとに、インターフェース、システムソフトウェア、現場検証を進め、サンプルを製品プロトタイプにします。
04
ASICを納入する
モデルが確定したら、量産チップを使うか、IPをお客様のシリコンに統合します。
ハードウェアは一度きりの購入です。トークンの請求は止まりません。いま使っているモデルを選び、1日あたりの処理量を動かしてみてください。
自社運用のクラウドGPUは100万トークンあたり $0.70 で試算(2026年のH100レンタル料金の中央値)。チップを一度購入したあとの推論1回あたりの限界コストは ≈ 0 です。
3年間の推論コスト
最初の1か月以内に回収
単価は2026年の公開API価格をもとにした概算(入力:出力 ≈ 1:1)。参考値であり、実際のコストは利用量とお見積もりによります。