
Déplacer moins. Garder l'inférence sur l'appareil.
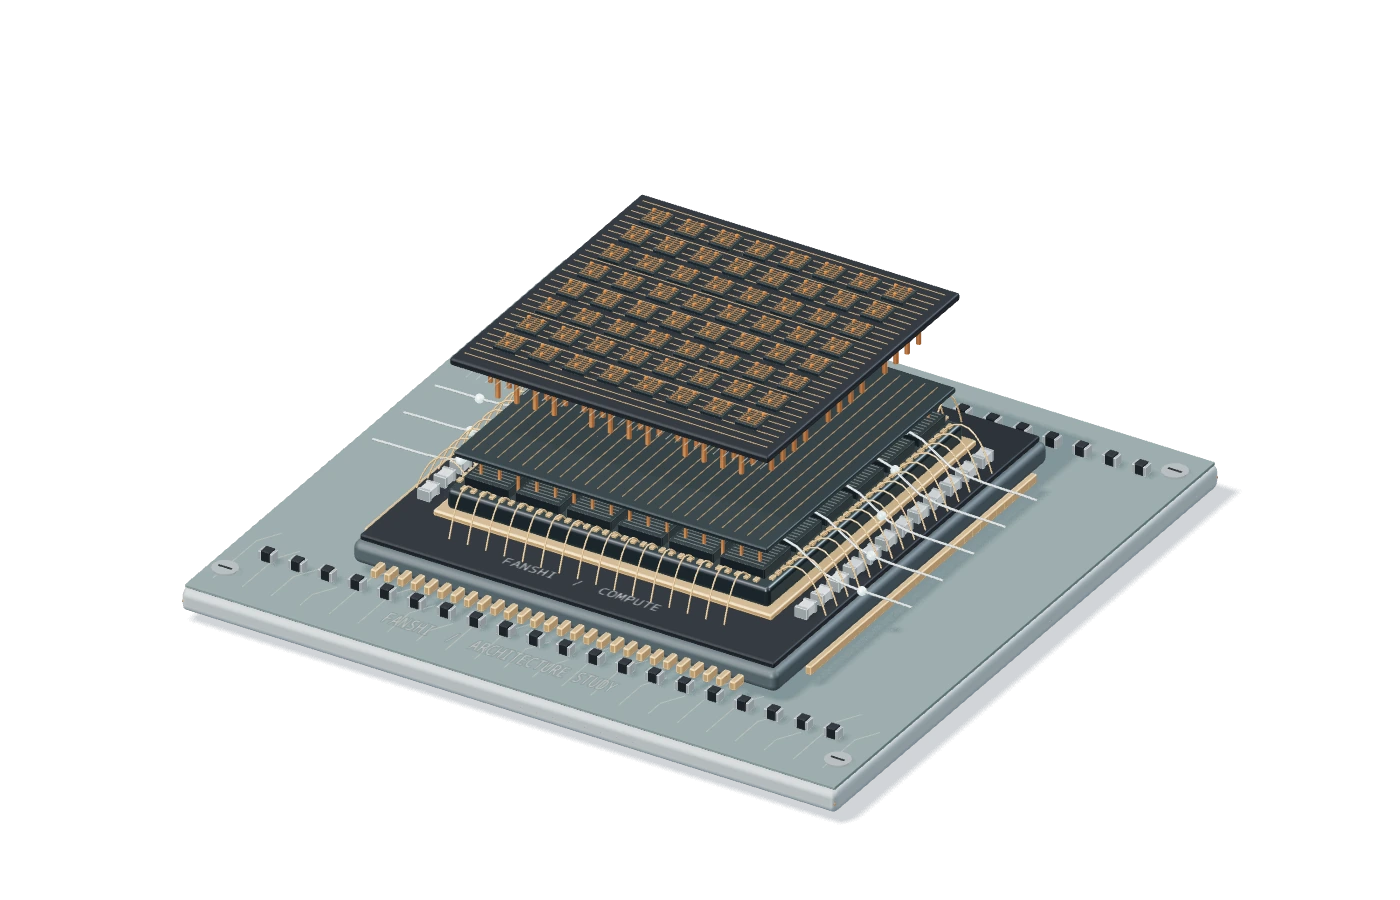
Fanshi organise sa technologie autour de l'endroit où les poids du modèle sont stockés et calculés : calcul en mémoire MaskROM, calcul en mémoire SRAM et calcul proche mémoire.

Graver le modèle entier
dans une seule puce.
Les GPU et les NPU passent l'essentiel de leur temps et de leur énergie à transporter les poids entre la mémoire et le calcul. Fanshi fait l'inverse : les poids résident dans la matrice mémoire, et le calcul se fait là où ils se trouvent.
Faire des poids une partie du silicium.
Transfert externe de poids par token
0MB
Ce qui reste à l'exécution
Calcul sur place · aucun transfert externe de poids
0.8B · estimation INT8, hors consommation du systèmeMémoire séparée
Chaque token déplace tous les poids
Dans un NPU ou un GPU classique, la mémoire et le calcul sont deux morceaux de silicium distincts. Pour chaque token généré, tous les poids traversent le bus : la bande passante fixe le plafond, et l'essentiel de l'énergie se perd en chemin.
Calcul en mémoire
Mettre les poids dans la matrice mémoire
Fanshi intègre les circuits de multiplication-accumulation dans la matrice mémoire elle-même. Les poids restent dans la matrice, les activations entrent, les résultats sortent. Plus aucun poids sur le bus.
MaskROM
Gravé au tape-out, jamais déplacé à l'exécution
Le calcul en mémoire sur ROM à masque inscrit physiquement les poids dans la matrice de vias lors du tape-out. La puce sort de l'usine avec le modèle déjà à l'intérieur : la consommation et le coût marginal par inférence tombent au minimum.
Un seul objectif,
trois voies.
Toutes trois déplacent moins les poids, voire plus du tout. Elles diffèrent par l'endroit où résident les poids et par la possibilité de modifier encore le modèle. La première question à trancher : à quelle fréquence votre modèle change-t-il ?
- Où résident les poids
- Couches de masque, gravées au tape-out
- Transferts à l'exécution
- Aucun
- Mise à jour du modèle
- Figé au tape-out
- Idéal pour
- Modèles stables, gros volumes, consommation et coût marginal les plus bas
- Où résident les poids
- Dans la matrice SRAM
- Transferts à l'exécution
- MAC dans la matrice
- Mise à jour du modèle
- Chargé au démarrage, modifiable
- Idéal pour
- Modèles de taille moyenne, appareils qui changent de modèle sur le terrain
- Où résident les poids
- Mémoire externe à large bande passante
- Transferts à l'exécution
- Flux orchestré sur la puce
- Mise à jour du modèle
- Itération continue
- Idéal pour
- Grands modèles en évolution rapide, nœuds à forte charge
Vitesse de décodage sur l'appareil
Objectif de conception Forge · Qwen 3.5 0.8B
Consommation du système
Forge, catégorie embarquée légère
Des données restent sur l'appareil
Inférence locale, sans réseau
Coût marginal par inférence
Après l'achat unique de la puce
Pour aller plus loin
 Qu'est-ce qu'une puce IA à calcul en mémoire ? Trois voies expliquéesUne puce IA à calcul en mémoire effectue la multiplication-accumulation dans la matrice mémoire : les poids ne bougent plus. Ce qui distingue MaskROM, SRAM CIM et calcul proche mémoire.
 Calcul en mémoire MaskROM : ce que signifie graver les poids dans le siliciumLe calcul en mémoire MaskROM inscrit les poids du modèle dans une matrice de vias à l'étape du masque : rien ne bouge à l'exécution. Fonctionnement, raisons du coût minimal, limites.
 Le mur de la mémoire : pourquoi les LLM embarqués calent, et comment le contournerLe décodage d'un LLM est limité par la bande passante : chaque token lit tous les poids, et les appareils embarqués ne tiennent pas ce trafic. La hauteur du mur, et comment le franchir.
Choisir la voie adaptée à votre projet
Envoyez le modèle cible, les objectifs de performance et de consommation, et la fréquence de changement du modèle. Nous répondons avec une voie et un plan d'évaluation.