

멀티모달 융합 추론 IP
FS-Fusion비전-언어 통합 이해(VLM)와 다중 센서 융합을 엣지 현장에서 바로 연산합니다.
SmolVLM + SegFormer MiT 융합 파이프라인 기본 지원
FS-Fusion 자세히 보기Fanshi는 대규모 언어 모델을 컴퓨트 인 메모리 실리콘에 직접 새겨 넣습니다. 세 가지 기술 경로, 하나의 추론 코어 제품군, 모델에서 테이프아웃까지 이어지는 하나의 라인. 네트워크가 필요 없고, 데이터는 기기를 벗어나지 않으며, 추론 한 번의 한계 비용은 0에 가깝습니다.
같은 추론 코어와 세 가지 기술 경로로 어떤 모델이든 칩에 새길 수 있습니다. 맞는 칩을 고르거나, 고객의 모델에 맞춰 하나를 만듭니다.
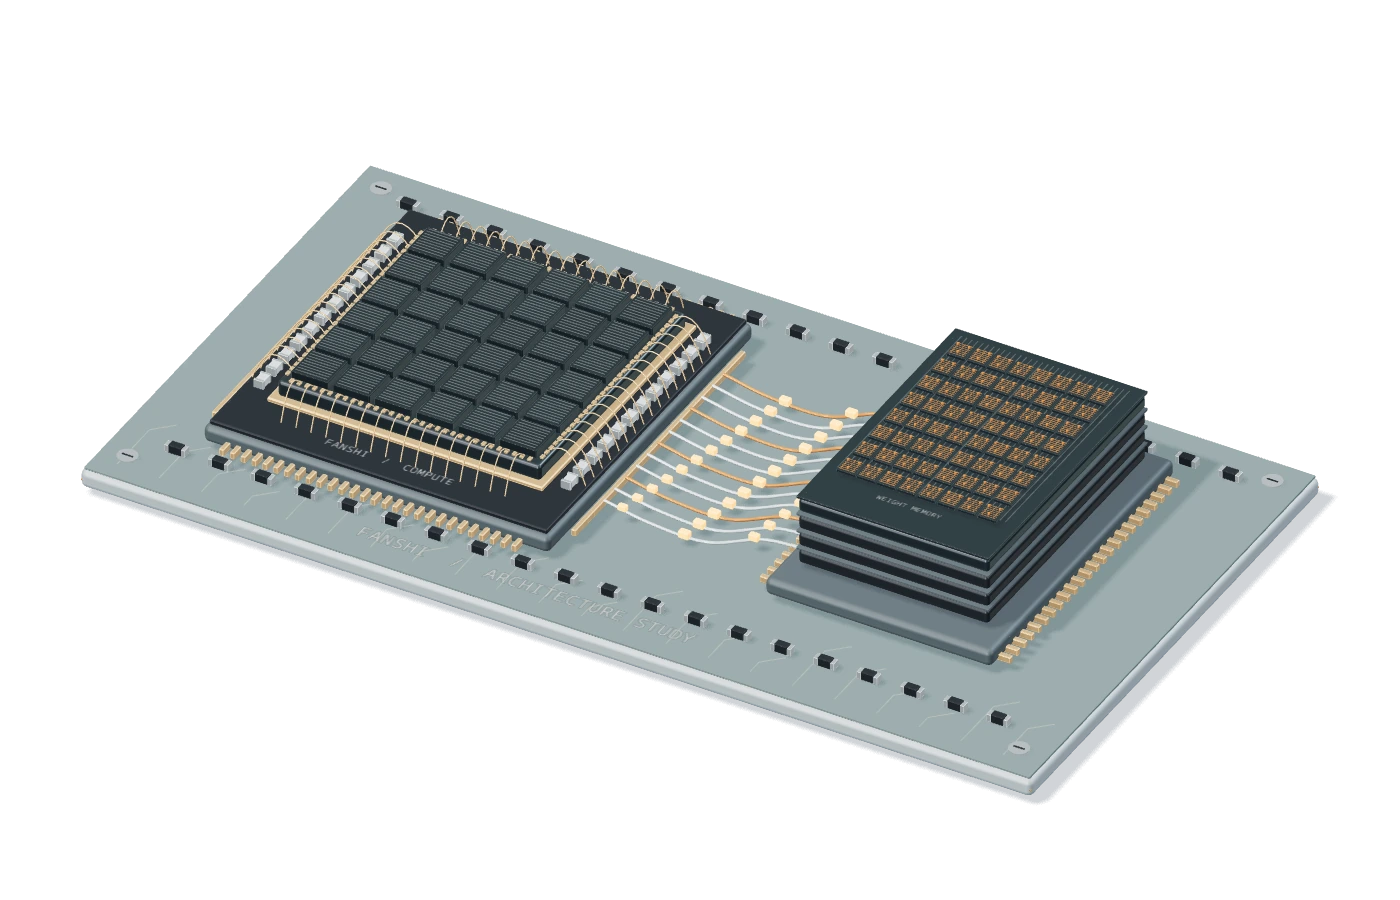
GPU와 NPU는 시간과 전력의 대부분을 메모리와 연산 장치 사이에서 가중치를 나르는 데 씁니다. Fanshi는 반대로 합니다. 가중치를 메모리 어레이에 두고, 그 자리에서 연산합니다.
가중치가 이동하고, 에너지도 이동한다.
토큰당 외부 가중치 이동량
800MB
이동이 발생하는 곳
칩 외부 읽기 · 칩 간 전송
0.8B · INT8 기준 추정치, 시스템 전력 아님메모리 분리
기존 NPU나 GPU에서는 메모리와 연산 장치가 서로 다른 실리콘입니다. 토큰 하나를 생성할 때마다 모든 가중치가 버스를 지나갑니다. 대역폭이 상한을 정하고, 에너지의 대부분은 이동에 쓰입니다.
컴퓨트 인 메모리
Fanshi는 곱셈-누산 회로를 메모리 어레이 자체에 넣습니다. 가중치는 어레이에 머물고, 활성화 값이 들어가고, 결과가 나옵니다. 버스 위에는 더 이상 가중치가 없습니다.
MaskROM
마스크 ROM 방식의 컴퓨트 인 메모리는 테이프아웃 과정에서 가중치를 비아 어레이에 물리적으로 기록합니다. 칩은 모델을 품은 채 출하되므로, 소비 전력과 추론당 한계 비용이 최소가 됩니다.
세 경로 모두 가중치 이동을 줄이거나 없앱니다. 차이는 가중치를 어디에 두는지, 모델을 나중에 바꿀 수 있는지입니다. 양산 칩은 각각 하나의 경로를 따릅니다. 맞춤 개발에서는 모델이 얼마나 자주 바뀌는지에 따라 경로를 정합니다.
온디바이스 디코딩 속도
Forge 설계 목표 · Qwen 3.5 0.8B
시스템 소비 전력
Forge, 경량 엣지 등급
데이터는 기기 안에
로컬 추론, 네트워크 불필요
추론당 한계 비용
칩을 한 번 구매한 뒤
부하에 맞춰 고르세요. 1와트급 휴대 기기, 350억 파라미터 모델을 돌리는 노드, 모든 프레임을 따라가는 비전 칩. 맞는 것이 없으면 고객의 모델에 맞춰 만듭니다.

1와트급 휴대 기기 안에 완전한 언어 모델을.
이 페이지의 수치는 현재의 제품 정의와 설계 목표입니다. 최종 사양, 시험 조건, 공급 상태, 납품 버전은 양측이 합의한 프로젝트 문서로 확정합니다.
Fanshi 추론 코어를 고객의 ASIC이나 FPGA에 라이선스합니다. 하나의 코어 제품군으로 네 가지 아키텍처를 지원하며, 먼저 평가 보드에서 구동합니다.
비전-언어 통합 이해(VLM)와 다중 센서 융합을 엣지 현장에서 바로 연산합니다.
SmolVLM + SegFormer MiT 융합 파이프라인 기본 지원
FS-Fusion 자세히 보기
하이브리드 어텐션 기반 언어 모델을 기본 지원합니다. Qwen3.5 제품군의 게이트 풀 어텐션 층을 포함합니다.
Qwen3 / 3.5 (0.6B~9B) 및 SmolLM2
FS-Attention 자세히 보기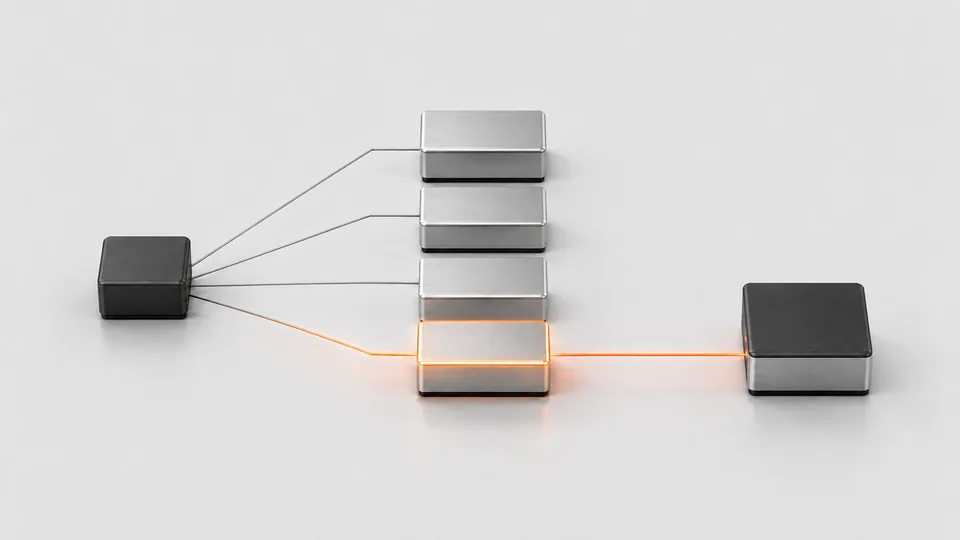
동적으로 활성화되는 희소 모델용입니다. 엣지의 대역폭 예산 안에서 큰 파라미터 수를 감당합니다.
엣지 예산으로 대형 희소 모델 구동
FS-MoE 자세히 보기
DeltaNet으로 대표되는 선형 어텐션과 RNN 계열 아키텍처를 지원합니다. Qwen3.5부터 쓰이는 Gated DeltaNet 층을 포함합니다.
컨텍스트가 아무리 길어도 상태 크기는 고정. 초저지연 스트리밍 처리
FS-Linear 자세히 보기평가 보드와 맞춤 가능한 IP 라이선스로 모델 매핑, 인터페이스, 시스템 전체 경로를 검증합니다. 실리콘보다 먼저 엔지니어링 샘플을 확보하므로, 설계 반영과 테이프아웃을 실측 결과에 근거해 판단할 수 있습니다.
IP 라이선스 문의
1세대 칩이 바로 이렇게 만들어졌습니다. 고객의 모델도 같은 길을 갈 수 있습니다. 먼저 평가 보드에서 구동한 뒤, 기존 칩을 쓸지 전용 칩을 만들지 결정합니다.
01
경로 선택
대상 모델, 성능 및 전력 목표, 업데이트 주기, 인터페이스. 첫 질문은 언제나 같습니다. 모델이 얼마나 자주 바뀝니까?
02
평가
평가 보드에서 모델을 구동해 정확도와 처리량을 측정합니다. 실리콘을 확정하기 전에 동작하는 엔지니어링 샘플을 확보합니다.
03
설계 반영
평가 결과를 바탕으로 인터페이스, 시스템 소프트웨어, 현장 검증을 진행해 샘플을 제품 프로토타입으로 만듭니다.
04
ASIC 납품
모델이 확정되면 양산 칩을 사용하거나, IP를 고객의 실리콘에 통합합니다.
하드웨어는 한 번만 구매합니다. 토큰 청구서는 끝나지 않습니다. 지금 쓰는 모델을 고르고 하루 처리량을 움직여 보세요.
자체 운영 클라우드 GPU는 100만 토큰당 $0.70로 추정했습니다(2026년 H100 임대료 중앙값). 칩을 한 번 구매한 뒤 추론당 한계 비용은 ≈ 0입니다.
3년간 추론 비용
첫 달 안에 회수
단가는 2026년 공개 API 가격을 종합한 추정치입니다(입력:출력 ≈ 1:1). 참고용이며 실제 비용은 사용량과 견적에 따라 달라집니다.