
IP d'inférence à fusion multimodale
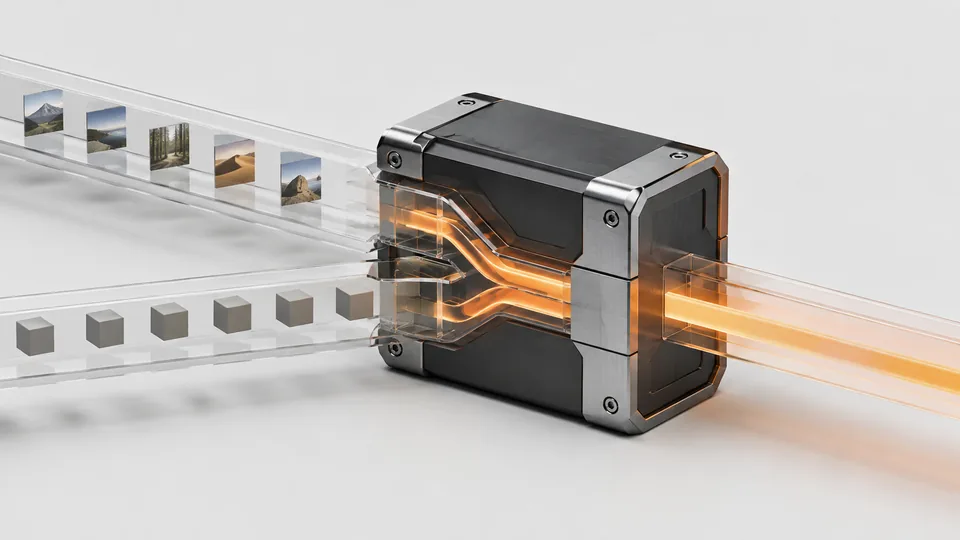
FS-FusionCompréhension conjointe vision-langage (VLM) et fusion multi-capteurs, calculées sur place en périphérie.
Pipeline de fusion SmolVLM + SegFormer MiT natif
Quatre cœurs d'inférence développés en interne couvrent la fusion multimodale, l'attention hybride, les experts parcimonieux et l'attention linéaire, tous avec prototypage FPGA.

Compréhension conjointe vision-langage (VLM) et fusion multi-capteurs, calculées sur place en périphérie.
Pipeline de fusion SmolVLM + SegFormer MiT natif

Prise en charge native des modèles de langage à attention hybride, y compris les couches d'attention complète à portes de la famille Qwen3.5.
Qwen3 / 3.5 (0.6B à 9B) et SmolLM2
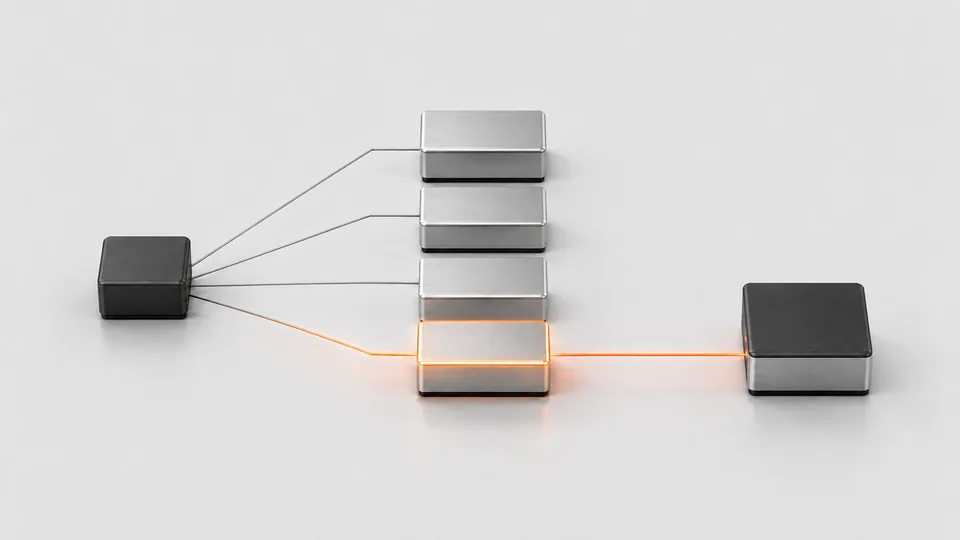
Conçue pour les modèles parcimonieux à activation dynamique : un grand nombre de paramètres dans un budget de bande passante embarqué.
Grands modèles parcimonieux dans un budget embarqué
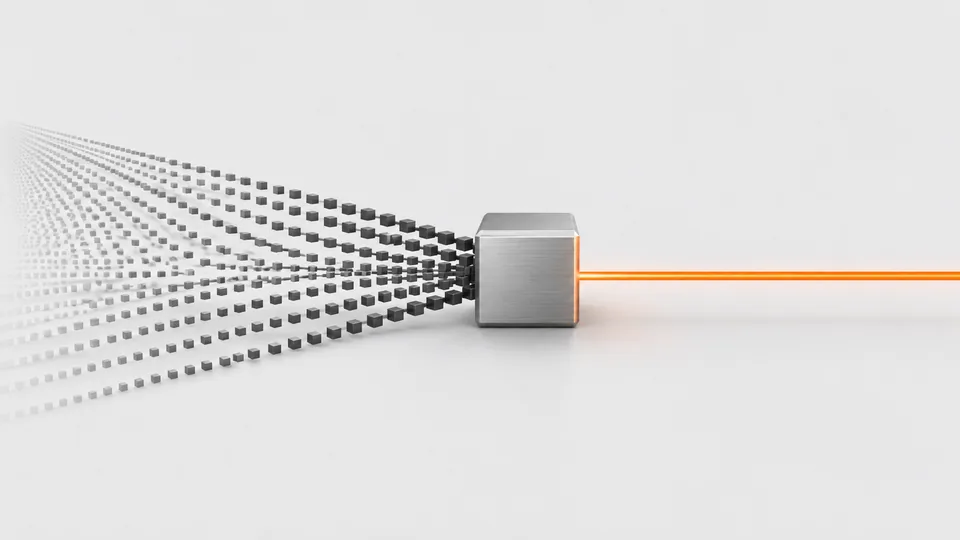
Attention linéaire et architectures de type RNN emmenées par DeltaNet, y compris les couches Gated DeltaNet utilisées à partir de Qwen3.5.
Traitement en flux à très faible latence avec un état de taille fixe, quelle que soit la longueur du contexte
La carte d'évaluation et une licence IP adaptable valident le mappage du modèle, les interfaces et toute la chaîne système. Un échantillon d'ingénierie existe avant le silicium : les décisions d'intégration et de tape-out reposent sur des mesures.

01
Choisir la voie
Modèle cible, objectifs de performance et de consommation, fréquence de mise à jour, interfaces. La première question est toujours la même : à quelle fréquence le modèle change-t-il ?
02
Évaluer
Faire tourner le modèle sur la carte d'évaluation, mesurer la précision et le débit, et obtenir un échantillon d'ingénierie fonctionnel avant tout engagement sur le silicium.
03
Intégrer
Interfaces, logiciel système et validation sur le terrain construits autour des résultats d'évaluation, pour transformer l'échantillon en prototype de produit.
04
Livrer l'ASIC
Une fois le modèle figé : une puce de série, ou l'IP intégrée à votre propre silicium.
Prototypage FPGA pour accélérateurs LLM : de la licence IP au tape-outFaire tourner un cœur d'inférence LLM sur FPGA avant le tape-out valide le mappage du modèle, les interfaces et la chaîne système. Ce que couvre une licence IP, étape par étape. De Qwen3.5 à Qwen3.8 : pourquoi l'attention hybride convient au silicium embarquéQwen3.5, 3.6 et 3.8 alternent attention linéaire Gated DeltaNet et attention complète à portes dans un rapport 3:1. Pourquoi cette disposition maîtrise la mémoire sur une puce IA embarquée.
 Le mur de la mémoire : pourquoi les LLM embarqués calent, et comment le contournerLe décodage d'un LLM est limité par la bande passante : chaque token lit tous les poids, et les appareils embarqués ne tiennent pas ce trafic. La hauteur du mur, et comment le franchir.
Indiquez-nous le composant cible, le modèle et les interfaces. Nous répondons avec la couverture IP et un plan d'évaluation.