

Inferenz-IP für multimodale Fusion
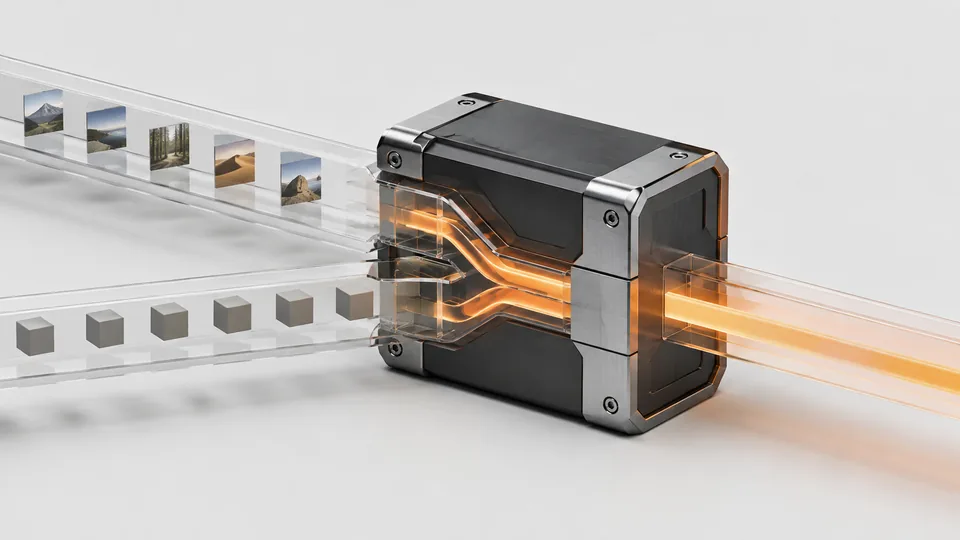
FS-FusionGemeinsames Bild-Sprach-Verständnis (VLM) und Multisensor-Fusion, direkt im Endgerät berechnet.
Native Fusions-Pipeline SmolVLM + SegFormer MiT
Details zu FS-FusionFanshi gießt große Sprachmodelle direkt in Compute-in-Memory-Silizium: drei Technologiepfade, eine Familie von Inferenzkernen, eine Linie vom Modell bis zum Tape-out. Ohne Netzwerk, ohne dass Daten das Gerät verlassen, mit Grenzkosten pro Inferenz nahe null.
Dieselben Inferenzkerne und drei Technologiepfade können jedes Modell in einen Chip gießen. Wählen Sie einen passenden, oder lassen Sie einen um Ihr Modell herum entwickeln.
GPUs und NPUs verbringen den Großteil ihrer Zeit und Energie damit, Gewichte zwischen Speicher und Rechenwerk hin- und herzuschieben. Fanshi dreht das um: Die Gewichte wohnen im Speicherarray, und gerechnet wird dort, wo sie liegen.
Gewichte unterwegs, Energie unterwegs.
Externer Gewichtstransport pro Token
800MB
Der Transport entsteht durch
Lesen außerhalb des Chips · Transfer zwischen Chips
0.8B · INT8-Schätzung, nicht die Leistungsaufnahme des SystemsGetrennter Speicher
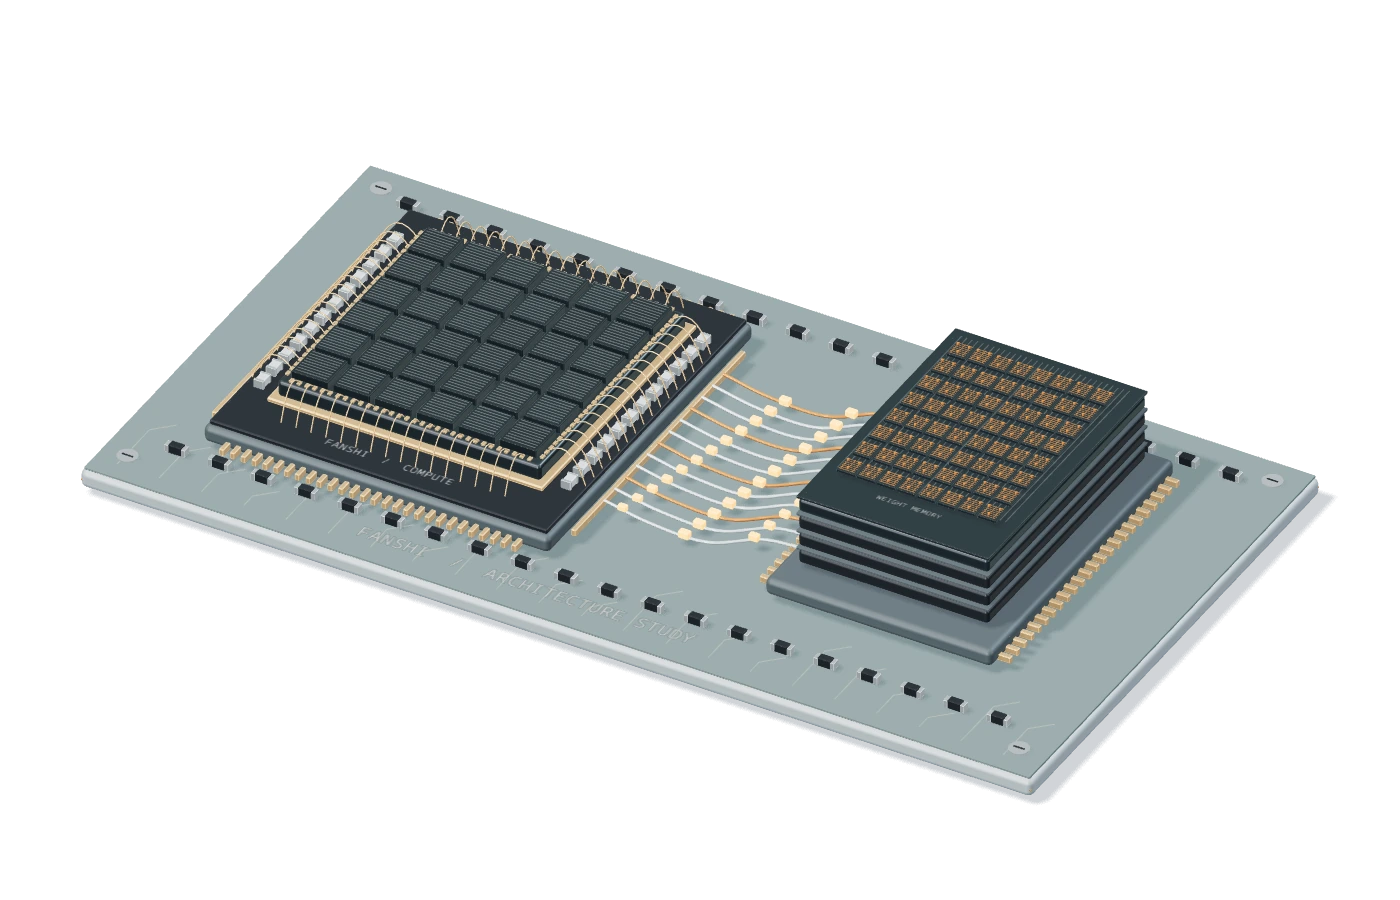
In einer herkömmlichen NPU oder GPU sind Speicher und Rechenwerk getrennte Siliziumbausteine. Für jedes erzeugte Token wandern sämtliche Gewichte über den Bus: Die Bandbreite setzt die Obergrenze, und die meiste Energie geht unterwegs verloren.
Compute-in-Memory
Fanshi baut die Multiplizier-Akkumulier-Schaltungen direkt in das Speicherarray. Die Gewichte bleiben im Array, Aktivierungen fließen hinein, Ergebnisse heraus. Auf dem Bus liegen keine Gewichte mehr.
MaskROM
Masken-ROM-Compute-in-Memory schreibt die Gewichte beim Tape-out physisch in das Via-Array. Der Chip verlässt die Fabrik mit dem Modell bereits im Inneren; Leistungsaufnahme und Grenzkosten pro Inferenz sinken auf das Minimum.
Alle drei bewegen die Gewichte weniger oder gar nicht. Sie unterscheiden sich darin, wo die Gewichte liegen und ob sich das Modell noch ändern lässt. Jeder Serienchip folgt einem Pfad; bei einem kundenspezifischen Chip richtet sich der Pfad danach, wie oft sich Ihr Modell ändert.
Dekodiergeschwindigkeit im Gerät
Forge, Entwicklungsziel · Qwen 3.5 0.8B
Leistungsaufnahme des Systems
Forge, leichte Edge-Klasse
Der Daten bleiben im Gerät
Lokale Inferenz, kein Netzwerk nötig
Grenzkosten pro Inferenz
Nach dem einmaligen Kauf des Chips
Wählen Sie nach Last: ein Handgerät der Watt-Klasse, ein Knoten für Modelle mit 35 Milliarden Parametern oder ein Vision-Chip, der mit jedem Bild Schritt hält. Passt keiner, bauen wir einen um Ihr Modell.

Ein vollständiges Sprachmodell in einem Handgerät der Watt-Klasse.
Typische Anwendungen
Die Angaben auf dieser Seite sind aktuelle Produktdefinitionen und Entwicklungsziele. Endgültige Spezifikationen, Testbedingungen, Verfügbarkeit und Lieferversionen werden in den von beiden Seiten abgestimmten Projektunterlagen festgelegt.
Lizenzieren Sie Fanshi-Inferenzkerne für Ihren eigenen ASIC oder FPGA. Eine Kernfamilie, vier Architekturen, zuerst auf einem Evaluierungsboard.
Gemeinsames Bild-Sprach-Verständnis (VLM) und Multisensor-Fusion, direkt im Endgerät berechnet.
Native Fusions-Pipeline SmolVLM + SegFormer MiT
Details zu FS-Fusion
Native Unterstützung für Sprachmodelle mit hybrider Attention, einschließlich der Gated-Full-Attention-Schichten der Qwen3.5-Familie.
Qwen3 / 3.5 (0.6B bis 9B) und SmolLM2
Details zu FS-Attention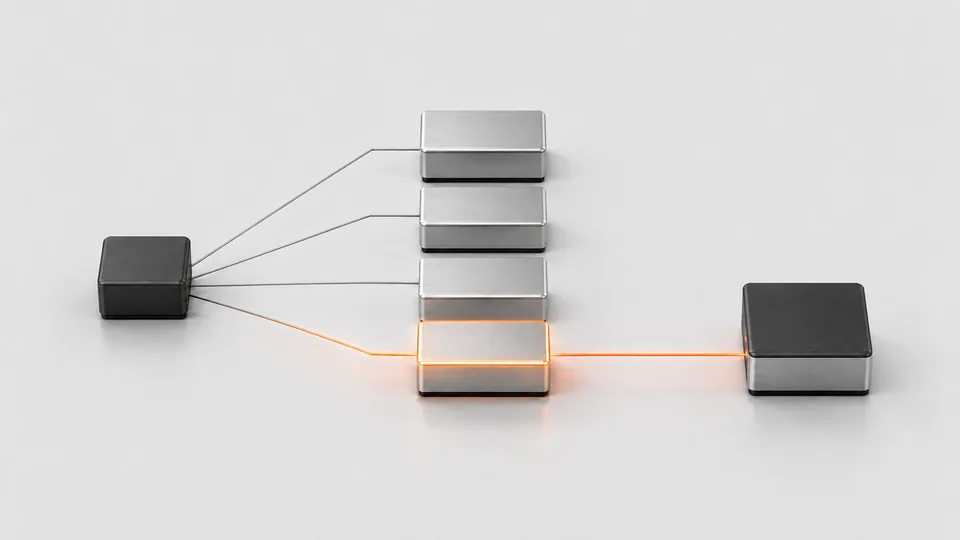
Für dynamisch aktivierte Sparse-Modelle: große Parameterzahlen innerhalb eines Edge-Bandbreitenbudgets.
Große Sparse-Modelle im Edge-Budget
Details zu FS-MoE
Lineare Attention und RNN-artige Architekturen rund um DeltaNet, einschließlich der seit Qwen3.5 verwendeten Gated-DeltaNet-Schichten.
Streaming mit sehr niedriger Latenz und Zustand fester Größe, unabhängig von der Kontextlänge
Details zu FS-LinearEvaluierungsboard und anpassbare IP-Lizenz validieren Modell-Mapping, Schnittstellen und den gesamten Systempfad. Ein Engineering-Muster existiert vor dem Silizium, sodass Design-in- und Tape-out-Entscheidungen auf Messwerten beruhen.
IP-Lizenzen anfragen
So sind die Chips der ersten Generation entstanden, und Ihrer kann denselben Weg gehen: zuerst auf einem Evaluierungsboard, dann die Wahl zwischen einem vorhandenen Chip und Ihrem eigenen.
01
Pfad wählen
Zielmodell, Leistungs- und Verbrauchsziele, Update-Rhythmus, Schnittstellen. Die erste Frage lautet immer: Wie oft ändert sich das Modell?
02
Evaluieren
Das Modell auf dem Evaluierungsboard ausführen, Genauigkeit und Durchsatz messen und ein funktionierendes Engineering-Muster erhalten, bevor Silizium beauftragt wird.
03
Integrieren
Schnittstellen, Systemsoftware und Feldvalidierung auf Basis der Evaluierungsergebnisse: Aus dem Muster wird ein Produktprototyp.
04
ASIC liefern
Sobald das Modell eingefroren ist: ein Serienchip oder die IP, integriert in Ihr eigenes Silizium.
Hardware kauft man einmal. Eine Token-Rechnung hört nie auf. Wählen Sie das Modell, das Sie heute nutzen, und ziehen Sie das Tagesvolumen.
Selbst betriebene Cloud-GPU, geschätzt $0.70 pro Million Token (mittlere H100-Miete 2026). Nach dem einmaligen Kauf des Chips sind die Grenzkosten pro Inferenz ≈ 0.
Inferenzkosten über drei Jahre
Amortisiert im ersten Monat
Preise: öffentliche API-Listenpreise 2026, gemittelt (Eingabe:Ausgabe ≈ 1:1). Nur zur Veranschaulichung; die tatsächlichen Kosten hängen von Nutzung und Angebot ab.