
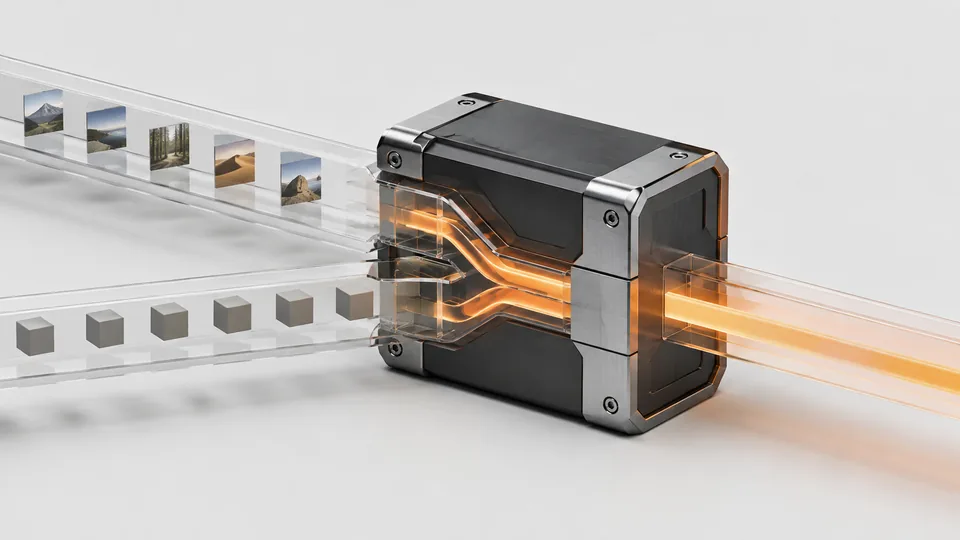
Inferenz-IP für multimodale Fusion
FS-FusionGemeinsames Bild-Sprach-Verständnis (VLM) und Multisensor-Fusion, direkt im Endgerät berechnet.
Native Fusions-Pipeline SmolVLM + SegFormer MiT
Vier selbst entwickelte Inferenzkerne decken multimodale Fusion, hybride Attention, Sparse-Experten und lineare Attention ab, alle mit FPGA-Prototyping.

Gemeinsames Bild-Sprach-Verständnis (VLM) und Multisensor-Fusion, direkt im Endgerät berechnet.
Native Fusions-Pipeline SmolVLM + SegFormer MiT

Native Unterstützung für Sprachmodelle mit hybrider Attention, einschließlich der Gated-Full-Attention-Schichten der Qwen3.5-Familie.
Qwen3 / 3.5 (0.6B bis 9B) und SmolLM2
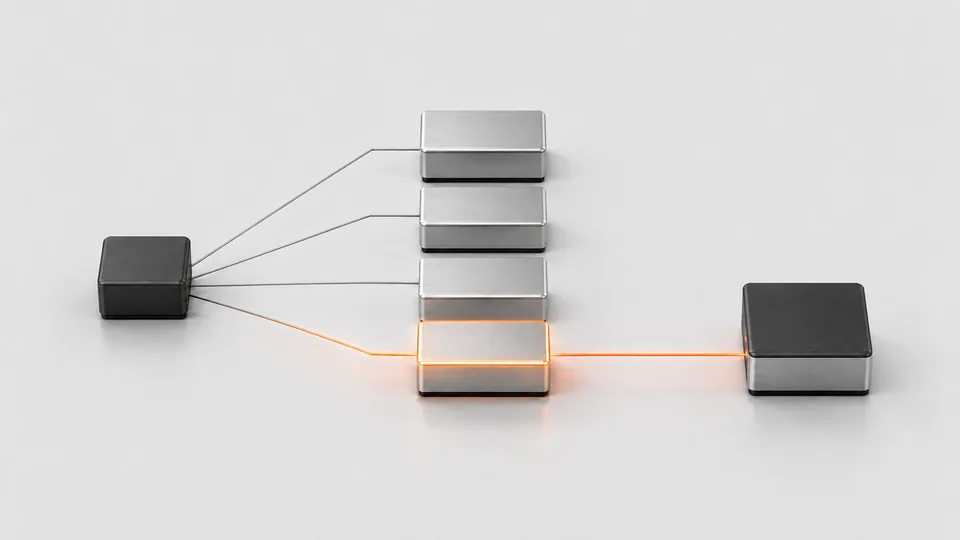
Für dynamisch aktivierte Sparse-Modelle: große Parameterzahlen innerhalb eines Edge-Bandbreitenbudgets.
Große Sparse-Modelle im Edge-Budget
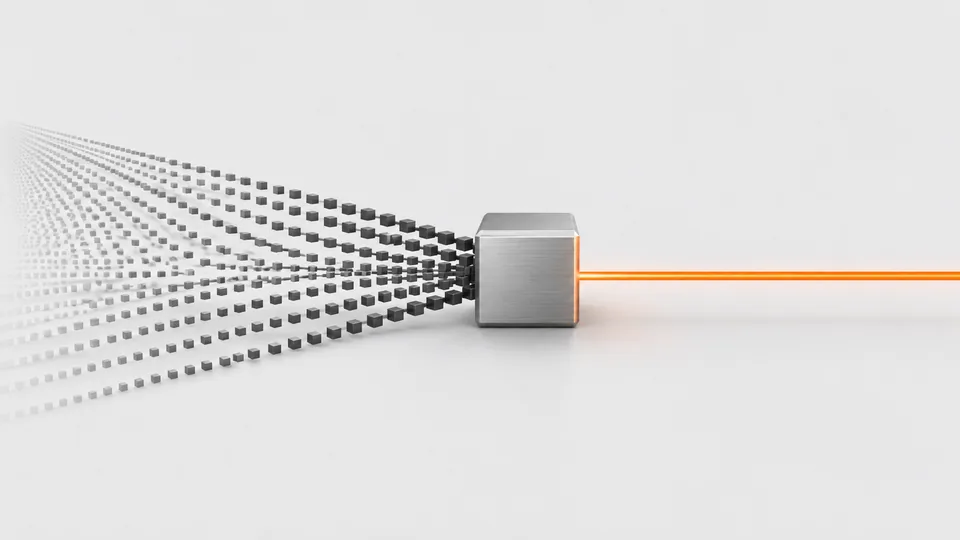
Lineare Attention und RNN-artige Architekturen rund um DeltaNet, einschließlich der seit Qwen3.5 verwendeten Gated-DeltaNet-Schichten.
Streaming mit sehr niedriger Latenz und Zustand fester Größe, unabhängig von der Kontextlänge
Evaluierungsboard und anpassbare IP-Lizenz validieren Modell-Mapping, Schnittstellen und den gesamten Systempfad. Ein Engineering-Muster existiert vor dem Silizium, sodass Design-in- und Tape-out-Entscheidungen auf Messwerten beruhen.

01
Pfad wählen
Zielmodell, Leistungs- und Verbrauchsziele, Update-Rhythmus, Schnittstellen. Die erste Frage lautet immer: Wie oft ändert sich das Modell?
02
Evaluieren
Das Modell auf dem Evaluierungsboard ausführen, Genauigkeit und Durchsatz messen und ein funktionierendes Engineering-Muster erhalten, bevor Silizium beauftragt wird.
03
Integrieren
Schnittstellen, Systemsoftware und Feldvalidierung auf Basis der Evaluierungsergebnisse: Aus dem Muster wird ein Produktprototyp.
04
ASIC liefern
Sobald das Modell eingefroren ist: ein Serienchip oder die IP, integriert in Ihr eigenes Silizium.
FPGA-Prototyping für LLM-Beschleuniger: von der IP-Lizenz zum Tape-outEin LLM-Inferenzkern auf einem FPGA vor dem Tape-out validiert Modell-Mapping, Schnittstellen und den Systempfad. Was eine IP-Lizenz abdeckt, Schritt für Schritt. Qwen3.5 bis Qwen3.8: Warum hybride Attention zu Edge-Silizium passtQwen3.5, 3.6 und 3.8 wechseln lineare Attention (Gated DeltaNet) und Gated Full Attention im Verhältnis 3:1 ab. Warum dieser Aufbau den Speicherbedarf auf Edge-KI-Silizium im Zaum hält.
 Die Memory Wall: Warum Edge-LLMs stocken und wie man sie umgehtLLM-Dekodierung ist durch die Bandbreite begrenzt: Jedes Token liest alle Gewichte, und Endgeräte verkraften diesen Datenverkehr nicht. Wie hoch die Mauer ist und wie man vorbeikommt.
Nennen Sie uns Zielbaustein, Modell und Schnittstellen. Wir antworten mit der IP-Abdeckung und einem Evaluierungsplan.