
Weniger bewegen. Die Inferenz bleibt im Gerät.
Fanshi ordnet seine Technologie danach, wo die Modellgewichte gespeichert und verrechnet werden: MaskROM-Compute-in-Memory, SRAM-Compute-in-Memory und Near-Memory-Computing.

Das ganze Modell,
gegossen in einen Chip.
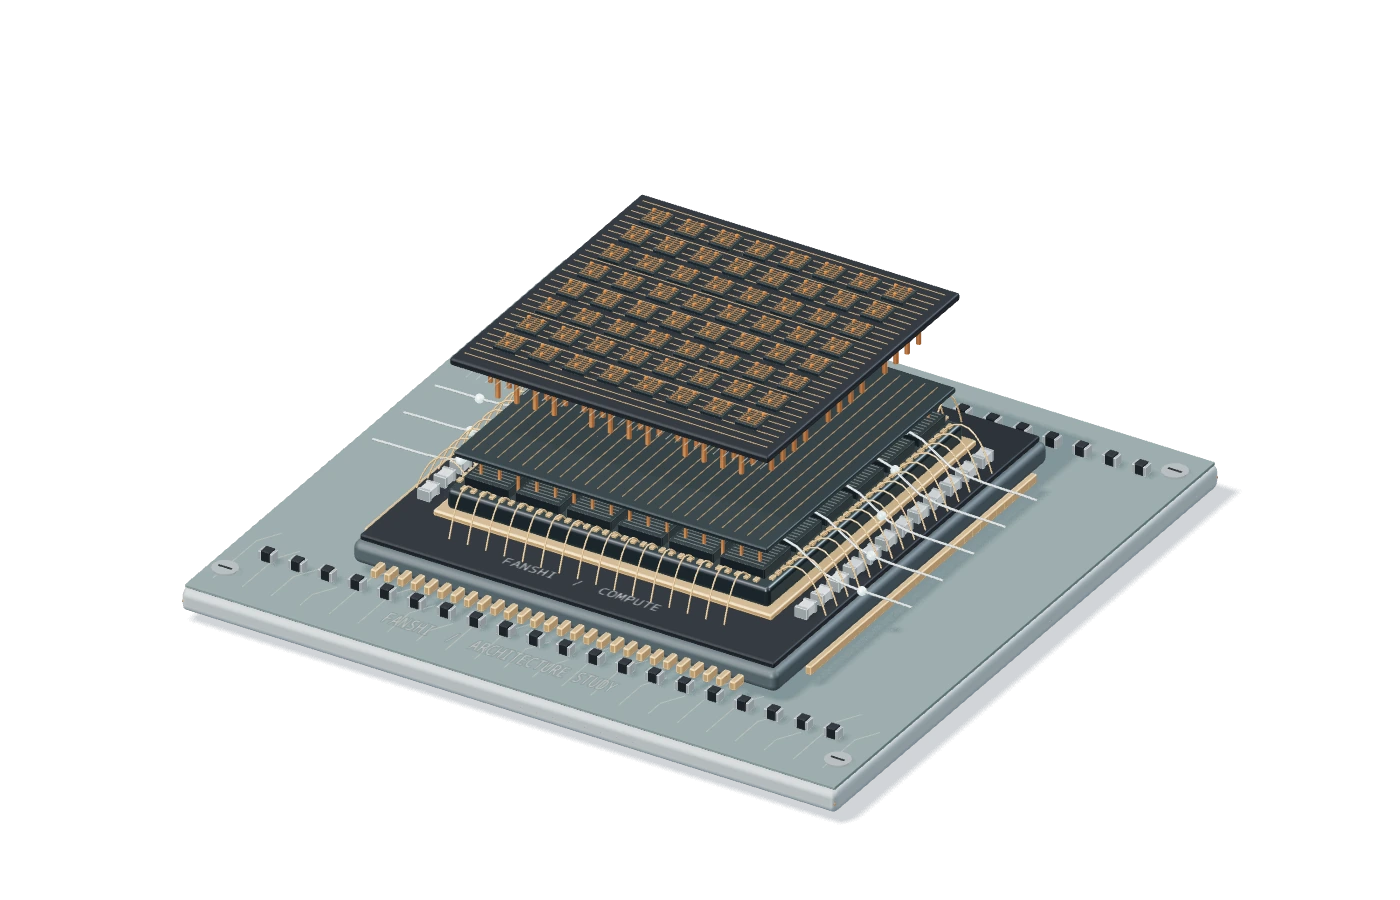
GPUs und NPUs verbringen den Großteil ihrer Zeit und Energie damit, Gewichte zwischen Speicher und Rechenwerk hin- und herzuschieben. Fanshi dreht das um: Die Gewichte wohnen im Speicherarray, und gerechnet wird dort, wo sie liegen.
Die Gewichte zum Teil des Siliziums machen.
Externer Gewichtstransport pro Token
0MB
Was zur Laufzeit bleibt
Rechnen an Ort und Stelle · kein externer Gewichtstransport
0.8B · INT8-Schätzung, nicht die Leistungsaufnahme des SystemsGetrennter Speicher
Jedes Token bewegt jedes Gewicht
In einer herkömmlichen NPU oder GPU sind Speicher und Rechenwerk getrennte Siliziumbausteine. Für jedes erzeugte Token wandern sämtliche Gewichte über den Bus: Die Bandbreite setzt die Obergrenze, und die meiste Energie geht unterwegs verloren.
Compute-in-Memory
Die Gewichte ins Speicherarray legen
Fanshi baut die Multiplizier-Akkumulier-Schaltungen direkt in das Speicherarray. Die Gewichte bleiben im Array, Aktivierungen fließen hinein, Ergebnisse heraus. Auf dem Bus liegen keine Gewichte mehr.
MaskROM
Beim Tape-out gegossen, zur Laufzeit nie bewegt
Masken-ROM-Compute-in-Memory schreibt die Gewichte beim Tape-out physisch in das Via-Array. Der Chip verlässt die Fabrik mit dem Modell bereits im Inneren; Leistungsaufnahme und Grenzkosten pro Inferenz sinken auf das Minimum.
Ein Ziel,
drei Pfade.
Alle drei bewegen die Gewichte weniger oder gar nicht. Sie unterscheiden sich darin, wo die Gewichte liegen und ob sich das Modell noch ändern lässt. Die erste Frage lautet: Wie oft ändert sich Ihr Modell?
- Wo die Gewichte liegen
- Maskenebenen, beim Tape-out gegossen
- Bewegung zur Laufzeit
- Keine
- Modell-Updates
- Beim Tape-out festgelegt
- Geeignet für
- Stabile Modelle, hohe Stückzahlen, niedrigste Leistungsaufnahme und Grenzkosten
- Wo die Gewichte liegen
- Im SRAM-Array
- Bewegung zur Laufzeit
- MAC im Array
- Modell-Updates
- Beim Start geladen, aktualisierbar
- Geeignet für
- Mittelgroße Modelle, Geräte mit Modellwechsel im Feld
- Wo die Gewichte liegen
- Externer Speicher mit hoher Bandbreite
- Bewegung zur Laufzeit
- Datenstrom auf dem Chip
- Modell-Updates
- Laufende Iteration
- Geeignet für
- Große, sich schnell entwickelnde Modelle in Hochlastknoten
Dekodiergeschwindigkeit im Gerät
Forge, Entwicklungsziel · Qwen 3.5 0.8B
Leistungsaufnahme des Systems
Forge, leichte Edge-Klasse
Der Daten bleiben im Gerät
Lokale Inferenz, kein Netzwerk nötig
Grenzkosten pro Inferenz
Nach dem einmaligen Kauf des Chips
Weiterlesen
 Was ist ein Compute-in-Memory-KI-Chip? Drei Pfade erklärtEin Compute-in-Memory-KI-Chip multipliziert und akkumuliert im Speicherarray, die Gewichte bewegen sich nicht mehr. Wie sich MaskROM, SRAM CIM und Near-Memory-Computing unterscheiden.
 MaskROM-Compute-in-Memory: Was es heißt, Gewichte ins Silizium zu gießenMaskROM-Compute-in-Memory schreibt die Modellgewichte in der Maskenstufe in ein Via-Array, zur Laufzeit bewegt sich nichts. Funktionsweise, Kostenvorteil und Grenzen.
 Die Memory Wall: Warum Edge-LLMs stocken und wie man sie umgehtLLM-Dekodierung ist durch die Bandbreite begrenzt: Jedes Token liest alle Gewichte, und Endgeräte verkraften diesen Datenverkehr nicht. Wie hoch die Mauer ist und wie man vorbeikommt.
Den passenden Pfad für Ihr Projekt wählen
Senden Sie uns Zielmodell, Leistungs- und Verbrauchsziele und wie oft sich das Modell ändert. Wir antworten mit einem Pfad und einem Evaluierungsplan.