

Forge
Edge-LLMLeichter Edge-Chip
Ein vollständiges Sprachmodell in einem Handgerät der Watt-Klasse.
17,000 token/s
Abb. 2 · Leichter Edge-Chip
Die ASICs der ersten Generation decken leichte Sprachmodelle, Hochlast-Inferenz und multimodale Vision ab. Mit denselben Kernen und Pfaden entsteht auch ein Chip rund um Ihr Modell.
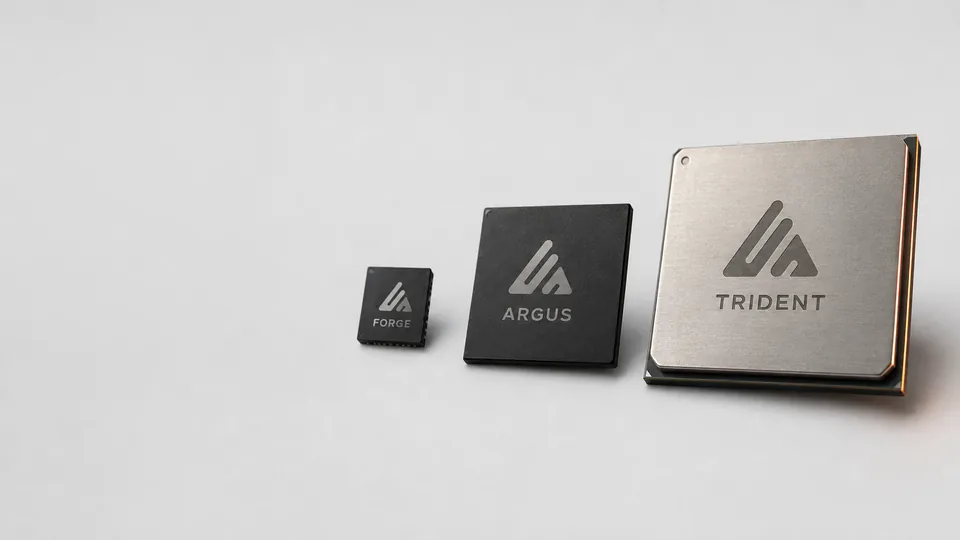
Leichter Edge-Chip
Ein vollständiges Sprachmodell in einem Handgerät der Watt-Klasse.
17,000 token/s
Abb. 2 · Leichter Edge-Chip

Flaggschiff-Chip für hohe Last
Ein 35B-Modell lokal mit 15.000 Token/s, bei 70 W Systembudget.
15,000 token/s
Abb. 3 · Flaggschiff-Chip für hohe Last

Multimodaler Vision-Chip
Pixelgenaue Bildinferenz in Echtzeit mit 120 FPS.
120 FPS
Abb. 4 · Multimodaler Vision-Chip

Für Ihr Modell gebaut
Ihr Modell, Ihr Chip. Dieselben Kerne und Pfade, neu definiert um Ihr Modell, Ihr Leistungsbudget und Ihre Stückzahl.
0.6B → 35B+ Modellbereich
Abb. 5 · Für Ihr Modell gebaut
Die Angaben auf dieser Seite sind aktuelle Produktdefinitionen und Entwicklungsziele. Endgültige Spezifikationen, Testbedingungen, Verfügbarkeit und Lieferversionen werden in den von beiden Seiten abgestimmten Projektunterlagen festgelegt.
Qwen3.5 → 3.6 → 3.8
Qwen3.6 und Qwen3.8 behalten den hybriden Aufbau von Qwen3.5 bei, den die Fanshi-Inferenzkerne bereits abbilden. Ein neueres Modell derselben Familie ist ein neuer Chip, keine Neuentwicklung.
01
Pfad wählen
Zielmodell, Leistungs- und Verbrauchsziele, Update-Rhythmus, Schnittstellen. Die erste Frage lautet immer: Wie oft ändert sich das Modell?
02
Evaluieren
Das Modell auf dem Evaluierungsboard ausführen, Genauigkeit und Durchsatz messen und ein funktionierendes Engineering-Muster erhalten, bevor Silizium beauftragt wird.
03
Integrieren
Schnittstellen, Systemsoftware und Feldvalidierung auf Basis der Evaluierungsergebnisse: Aus dem Muster wird ein Produktprototyp.
04
ASIC liefern
Sobald das Modell eingefroren ist: ein Serienchip oder die IP, integriert in Ihr eigenes Silizium.
Model-on-Chip erklärt: Fest verdrahtete LLM-ASICs, Cloud und EdgeEin Model-on-Chip-ASIC gießt die Gewichte eines einzelnen Modells fest ins Silizium und wird dadurch um Größenordnungen schneller. Funktionsweise, was der Taalas HC1 gezeigt hat, Cloud gegenüber Edge und Fragen an den Anbieter. Einen Edge-LLM-Inferenzchip auswählen: 7 FragenDie Wahl eines Edge-LLM-Inferenzchips hängt von der Modelleignung, dem Leistungsbudget und der Update-Strategie ab, nicht von Spitzen-TOPS. Sieben Fragen und eine Checkliste.
 LLM-Inferenzkosten: API, Cloud-GPU oder Edge-Chip über 3 JahreLLM-Inferenzkosten über drei Jahre gerechnet: eine API pro Token, eine Cloud-GPU pro Stunde oder ein einmal gekaufter Edge-Chip. Methode, Rechenbeispiel und Amortisation.
Senden Sie uns Zielmodell, Leistungsziel, Leistungsbudget und Schnittstellen. Wir bestätigen den Pfad und antworten mit einem Evaluierungsplan.