
덜 옮기고, 추론은 기기 안에서.
Fanshi는 모델 가중치를 어디에 저장하고 어디서 연산하는지를 기준으로 기술을 구성합니다. MaskROM 컴퓨트 인 메모리, SRAM 컴퓨트 인 메모리, 니어 메모리 컴퓨팅의 세 가지입니다.

모델 전체를
칩 하나에 새기다.
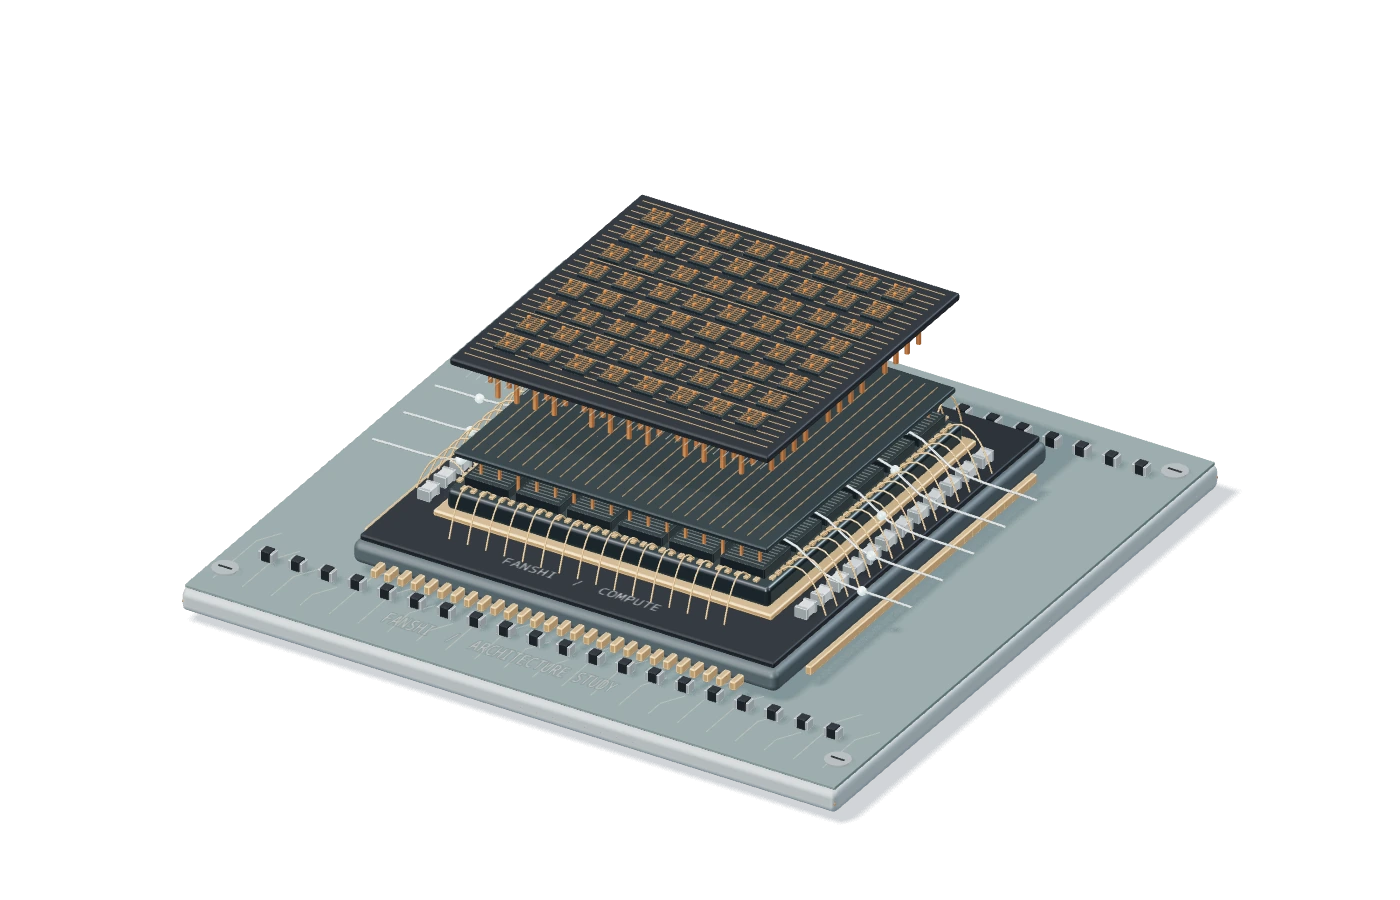
GPU와 NPU는 시간과 전력의 대부분을 메모리와 연산 장치 사이에서 가중치를 나르는 데 씁니다. Fanshi는 반대로 합니다. 가중치를 메모리 어레이에 두고, 그 자리에서 연산합니다.
가중치를 실리콘의 일부로 만든다.
토큰당 외부 가중치 이동량
0MB
실행 중 남는 것
제자리 연산 · 외부 가중치 이동 없음
0.8B · INT8 기준 추정치, 시스템 전력 아님메모리 분리
토큰마다 모든 가중치를 옮긴다
기존 NPU나 GPU에서는 메모리와 연산 장치가 서로 다른 실리콘입니다. 토큰 하나를 생성할 때마다 모든 가중치가 버스를 지나갑니다. 대역폭이 상한을 정하고, 에너지의 대부분은 이동에 쓰입니다.
컴퓨트 인 메모리
가중치를 메모리 어레이에 둔다
Fanshi는 곱셈-누산 회로를 메모리 어레이 자체에 넣습니다. 가중치는 어레이에 머물고, 활성화 값이 들어가고, 결과가 나옵니다. 버스 위에는 더 이상 가중치가 없습니다.
MaskROM
테이프아웃 때 새기고, 실행 중에는 옮기지 않는다
마스크 ROM 방식의 컴퓨트 인 메모리는 테이프아웃 과정에서 가중치를 비아 어레이에 물리적으로 기록합니다. 칩은 모델을 품은 채 출하되므로, 소비 전력과 추론당 한계 비용이 최소가 됩니다.
목표는 하나,
경로는 셋.
세 경로 모두 가중치 이동을 줄이거나 없앱니다. 차이는 가중치를 어디에 두는지, 모델을 나중에 바꿀 수 있는지입니다. 가장 먼저 답해야 할 질문은 모델이 얼마나 자주 바뀌는가입니다.
- 가중치의 위치
- 마스크 층, 테이프아웃 때 기록
- 실행 중 이동
- 없음
- 모델 업데이트
- 테이프아웃 때 고정
- 적합한 용도
- 모델이 안정적이고 물량이 많으며 최저 전력과 한계 비용이 필요한 제품
- 가중치의 위치
- SRAM 어레이 내부
- 실행 중 이동
- 어레이 내 곱셈-누산
- 모델 업데이트
- 부팅 시 로드, 업데이트 가능
- 적합한 용도
- 중간 규모 모델, 현장에서 모델을 교체해야 하는 기기
- 가중치의 위치
- 고대역폭 외부 메모리
- 실행 중 이동
- 온칩 스트리밍
- 모델 업데이트
- 지속적인 업데이트
- 적합한 용도
- 빠르게 변하는 대형 모델, 고부하 노드
온디바이스 디코딩 속도
Forge 설계 목표 · Qwen 3.5 0.8B
시스템 소비 전력
Forge, 경량 엣지 등급
데이터는 기기 안에
로컬 추론, 네트워크 불필요
추론당 한계 비용
칩을 한 번 구매한 뒤
함께 읽기
 컴퓨트 인 메모리 AI 칩이란? 세 가지 기술 경로 설명컴퓨트 인 메모리 AI 칩은 곱셈-누산을 메모리 어레이 안에서 수행해 가중치를 옮기지 않습니다. MaskROM, SRAM CIM, 니어 메모리 컴퓨팅의 차이를 설명합니다.
 MaskROM 컴퓨트 인 메모리: 가중치를 실리콘에 새긴다는 것MaskROM 컴퓨트 인 메모리는 마스크 단계에서 모델 가중치를 비아 어레이에 기록하므로 실행 중 아무것도 옮기지 않습니다. 동작 원리, 비용이 가장 낮은 이유, 그리고 한계.
 메모리 벽: 엣지 LLM이 멈추는 이유와 우회하는 방법LLM 디코딩은 대역폭에 묶여 있습니다. 토큰마다 모든 가중치를 읽기 때문에 엣지 기기는 그 전송량을 감당하지 못합니다. 벽이 얼마나 높은지, 어떻게 넘는지 설명합니다.
프로젝트에 맞는 경로 선택하기
대상 모델, 성능 및 전력 목표, 모델 변경 주기를 보내 주세요. 적합한 경로와 평가 계획을 회신해 드립니다.