

바로 쓸 수 있는 칩, 그리고 전용 칩으로 가는 길.
1세대 ASIC은 경량 언어 모델, 고부하 추론, 멀티모달 비전을 포괄합니다. 같은 코어와 경로로 고객의 모델에 맞춘 칩도 만들 수 있습니다.
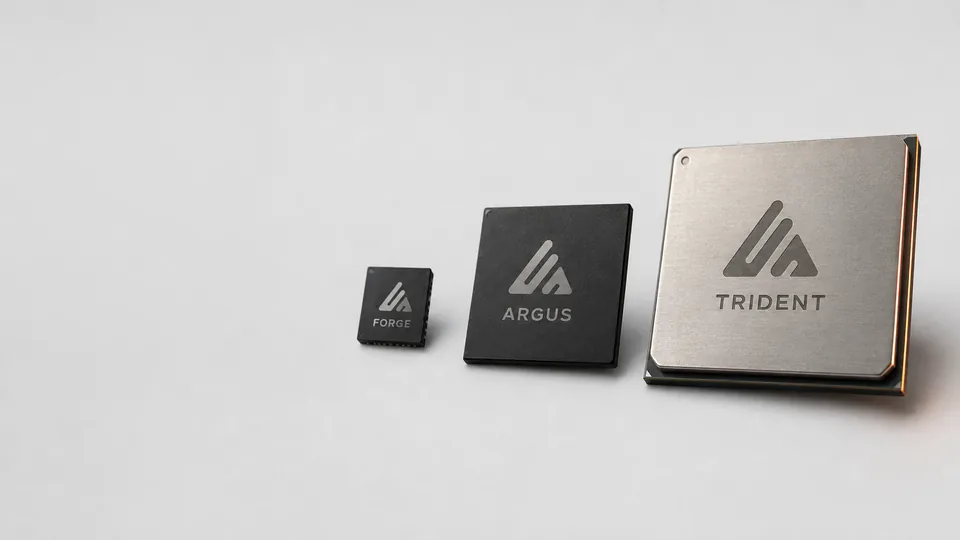

Trident
고부하 LLM플래그십 고부하 칩
35B 모델을 로컬에서 15,000 token/s로, 시스템 전력은 70 W.
15,000 token/s
그림 3 · 플래그십 고부하 칩


맞춤형 ASIC
고객 모델고객 모델 전용
당신의 모델, 당신의 칩. 같은 코어와 경로를 모델, 전력 예산, 물량에 맞춰 다시 정의합니다.
0.6B → 35B+ 모델 범위
그림 5 · 고객 모델 전용
이 페이지의 수치는 현재의 제품 정의와 설계 목표입니다. 최종 사양, 시험 조건, 공급 상태, 납품 버전은 양측이 합의한 프로젝트 문서로 확정합니다.
Qwen3.5 → 3.6 → 3.8
새 Qwen 모델이 나와도 아키텍처는 다시 설계하지 않습니다.
Qwen3.6과 Qwen3.8은 Qwen3.5의 하이브리드 구조를 유지하며, Fanshi 추론 코어는 이미 이를 지원합니다. 같은 제품군의 새 모델은 칩을 새로 구축하는 일이지 재설계가 아닙니다.
메일 한 통에서 칩 하나까지
01
경로 선택
대상 모델, 성능 및 전력 목표, 업데이트 주기, 인터페이스. 첫 질문은 언제나 같습니다. 모델이 얼마나 자주 바뀝니까?
02
평가
평가 보드에서 모델을 구동해 정확도와 처리량을 측정합니다. 실리콘을 확정하기 전에 동작하는 엔지니어링 샘플을 확보합니다.
03
설계 반영
평가 결과를 바탕으로 인터페이스, 시스템 소프트웨어, 현장 검증을 진행해 샘플을 제품 프로토타입으로 만듭니다.
04
ASIC 납품
모델이 확정되면 양산 칩을 사용하거나, IP를 고객의 실리콘에 통합합니다.
함께 읽기
- 모델 온 칩이란: LLM 을 하드와이어링한 ASIC, 클라우드와 엣지모델 온 칩(하드와이어드 LLM) ASIC 은 한 모델의 가중치를 실리콘에 고정해 속도를 몇 자릿수 끌어올립니다. 작동 원리, Taalas HC1 이 보여 준 것, 클라우드와 엣지의 차이, 공급사에 물어야 할 것을 정리합니다.
 엣지 LLM 추론 칩 선택법: 7가지 질문엣지 LLM 추론 칩 선택을 좌우하는 것은 최대 TOPS가 아니라 모델 적합성, 전력 예산, 업데이트 방식입니다. 답해야 할 일곱 가지 질문과 체크리스트.
 LLM 추론 비용: API, 클라우드 GPU, 엣지 칩의 3년 비교LLM 추론 비용을 3년 기준으로 계산합니다. 토큰당 과금하는 API, 시간당 과금하는 클라우드 GPU, 한 번 구매하는 엣지 칩. 계산 방법, 예시, 회수 기간.
평가 키트 신청
대상 모델, 성능 목표, 전력 예산, 인터페이스를 보내 주세요. 적합한 경로를 확인한 뒤 평가 계획을 회신해 드립니다.