

すぐ使えるチップと、専用チップへの道。
第1世代ASICは、軽量な言語モデル、高負荷の推論、マルチモーダル視覚をカバーします。同じコアとルートで、お客様のモデルに合わせたチップも作れます。
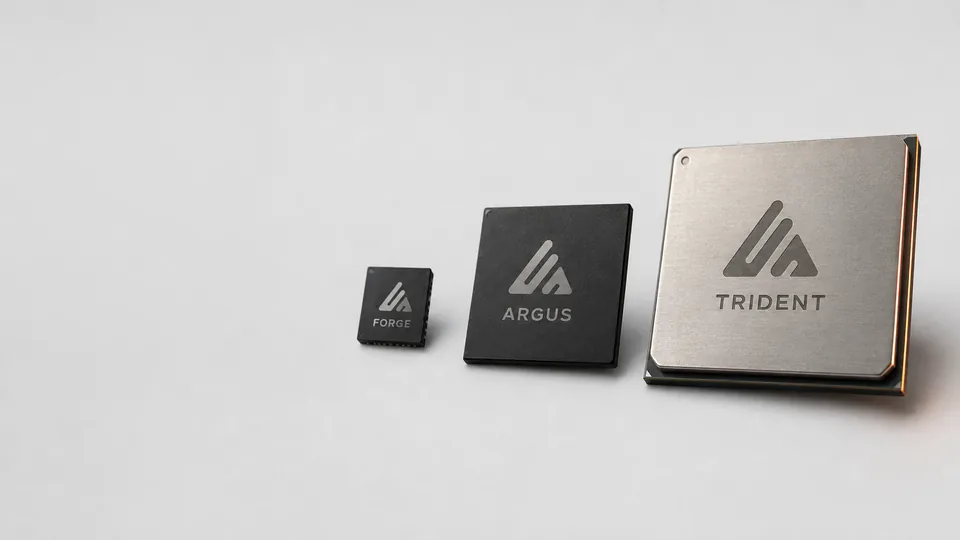

Trident
高負荷LLMフラッグシップ高負荷チップ
35Bモデルをローカルで 15,000 token/s、システム電力は70 W。
15,000 token/s
図3 · フラッグシップ高負荷チップ


カスタムASIC
お客様のモデルお客様のモデル専用
あなたのモデルを、あなたのチップに。同じコアとルートを、モデル、電力予算、出荷数に合わせて定義し直します。
0.6B → 35B+ モデル範囲
図5 · お客様のモデル専用
このページの数値は、現時点の製品定義と設計目標です。最終仕様、試験条件、供給状況、納入バージョンは、双方が合意したプロジェクト資料で確定します。
Qwen3.5 → 3.6 → 3.8
新しいQwenモデルでも、アーキテクチャは作り直しません。
Qwen3.6 と Qwen3.8 は Qwen3.5 のハイブリッド構成を引き継いでおり、Fanshiの推論コアはすでに対応しています。同じファミリーの新しいモデルは、チップの新規構築であって、再設計ではありません。
1通のメールから、1つのチップへ
01
ルートを選ぶ
対象モデル、性能と消費電力の目標、更新頻度、インターフェース。最初の問いはいつも同じです。そのモデルはどのくらいの頻度で変わりますか。
02
評価する
評価ボード上でモデルを動かし、精度とスループットを測定します。シリコンを確定する前に、動作するエンジニアリングサンプルが手に入ります。
03
設計に組み込む
評価結果をもとに、インターフェース、システムソフトウェア、現場検証を進め、サンプルを製品プロトタイプにします。
04
ASICを納入する
モデルが確定したら、量産チップを使うか、IPをお客様のシリコンに統合します。
関連記事
- モデルオンチップとは:LLM を固定配線した ASIC、クラウドとエッジの違いモデルオンチップ(ハードワイヤード LLM)ASIC は、ひとつのモデルの重みをシリコンに固定し、桁違いの速度を得ます。仕組み、Taalas HC1 が示したこと、クラウドとエッジの違い、ベンダーに確認すべき点を解説します。
 エッジLLM推論チップの選び方:7つの質問エッジLLM推論チップの選定を決めるのは、ピークTOPSではなく、モデルとの適合、電力予算、更新方法です。答えるべき7つの質問とチェックリスト。
 LLM推論コスト:API、クラウドGPU、エッジチップを3年間で比較LLM推論コストを3年間で計算します。トークン課金のAPI、時間課金のクラウドGPU、一度購入するエッジチップ。計算方法、具体例、回収期間。
評価キットを申し込む
対象モデル、性能目標、電力予算、インターフェースをお送りください。適したルートを確認し、評価計画をご返信します。