
動かす量を減らし、推論をデバイスの中に。
Fanshiは、モデルの重みをどこに置き、どこで演算するかを軸に技術を整理しています。MaskROM コンピュート・イン・メモリ、SRAM コンピュート・イン・メモリ、ニアメモリ演算の3つです。

モデルをまるごと、
1つのチップに焼き込む。
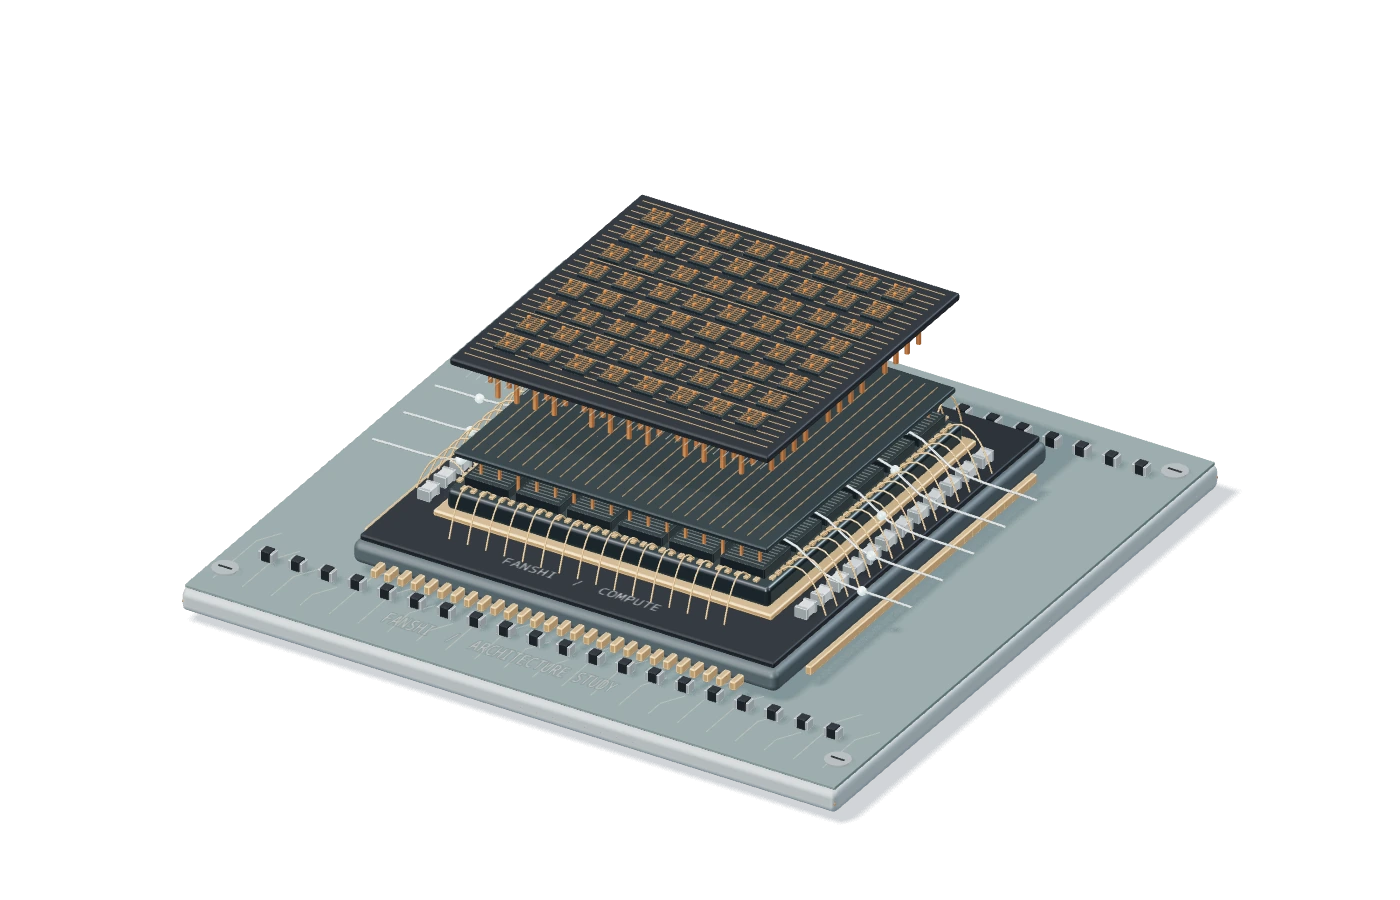
GPUやNPUは、時間と電力の大半を、メモリと演算器のあいだで重みを運ぶことに費やしています。Fanshiはその逆を行きます。重みをメモリアレイに住まわせ、その場で演算します。
重みをシリコンの一部にする。
トークンあたりの外部重み転送量
0MB
実行時に残るもの
その場で演算 · 外部からの重み転送なし
0.8B · INT8 での概算。システム消費電力ではありませんメモリ分離
トークンごとに全重みを運ぶ
従来のNPUやGPUでは、メモリと演算器は別々のシリコンです。トークンを1つ生成するたびに、すべての重みがバスを通ります。帯域が上限を決め、エネルギーの大半は移動に消えます。
コンピュート・イン・メモリ
重みをメモリアレイに置く
Fanshiは積和演算回路をメモリアレイそのものに組み込みます。重みはアレイにとどまり、活性化が流れ込み、結果が流れ出ます。バスの上に重みはもうありません。
MaskROM
テープアウトで焼き込み、実行時には動かさない
マスクROM方式のコンピュート・イン・メモリは、テープアウト時に重みをビアアレイへ物理的に書き込みます。チップは出荷時点でモデルを内蔵しており、消費電力と推論1回あたりの限界コストは最小になります。
目標は1つ、
ルートは3つ。
どのルートも、重みの移動を減らすか、なくします。違いは、重みをどこに置くか、モデルをあとから変えられるかです。最初に答えるべき問いは、そのモデルがどのくらいの頻度で変わるかです。
- 重みの置き場所
- マスク層。テープアウト時に焼き込み
- 実行時の移動
- なし
- モデル更新
- テープアウト時に固定
- 適した用途
- モデルが安定し、出荷数が多く、消費電力と限界コストを最小にしたい製品
- 重みの置き場所
- SRAMアレイ内
- 実行時の移動
- アレイ内で積和演算
- モデル更新
- 起動時にロード、更新可能
- 適した用途
- 中規模モデル、現場でモデルを入れ替える機器
- 重みの置き場所
- 高帯域の外部メモリ
- 実行時の移動
- チップ上のストリーミング
- モデル更新
- 継続的に更新
- 適した用途
- 進化の速い大規模モデル、高負荷ノード
デバイス上のデコード速度
Forge 設計目標 · Qwen 3.5 0.8B
システム消費電力
Forge、軽量エッジクラス
データはデバイス内に
ローカル推論、ネットワーク不要
推論1回あたりの限界コスト
チップを一度購入したあと
関連記事
 コンピュート・イン・メモリAIチップとは? 3つの技術ルートを解説コンピュート・イン・メモリAIチップは、積和演算をメモリアレイの中で行い、重みを動かしません。MaskROM、SRAM CIM、ニアメモリ演算の違いを解説します。
 MaskROM コンピュート・イン・メモリ:重みをシリコンに焼き込むとはMaskROM コンピュート・イン・メモリは、マスク工程でモデルの重みをビアアレイに書き込み、実行時には何も動かしません。仕組み、コストが最小になる理由、そして限界。
 メモリの壁:エッジLLMが止まる理由と、その回避策LLMのデコードは帯域に律速されます。トークンごとにすべての重みを読むため、エッジ機器はその転送量に耐えられません。壁の高さと、越え方を解説します。
プロジェクトに合ったルートを選ぶ
対象モデル、性能と消費電力の目標、モデルの更新頻度をお送りください。適したルートと評価計画をご返信します。