
Меньше переносить. Оставить инференс на устройстве.
Fanshi выстраивает технологию вокруг того, где хранятся и обрабатываются веса модели: вычисления в памяти на MaskROM, вычисления в памяти на SRAM и вычисления рядом с памятью.

Вся модель целиком —
в одном чипе.
GPU и NPU тратят большую часть времени и энергии на перенос весов между памятью и вычислителем. Fanshi поступает наоборот: веса живут в массиве памяти, а вычисления выполняются там же, где они лежат.
Сделать веса частью кремния.
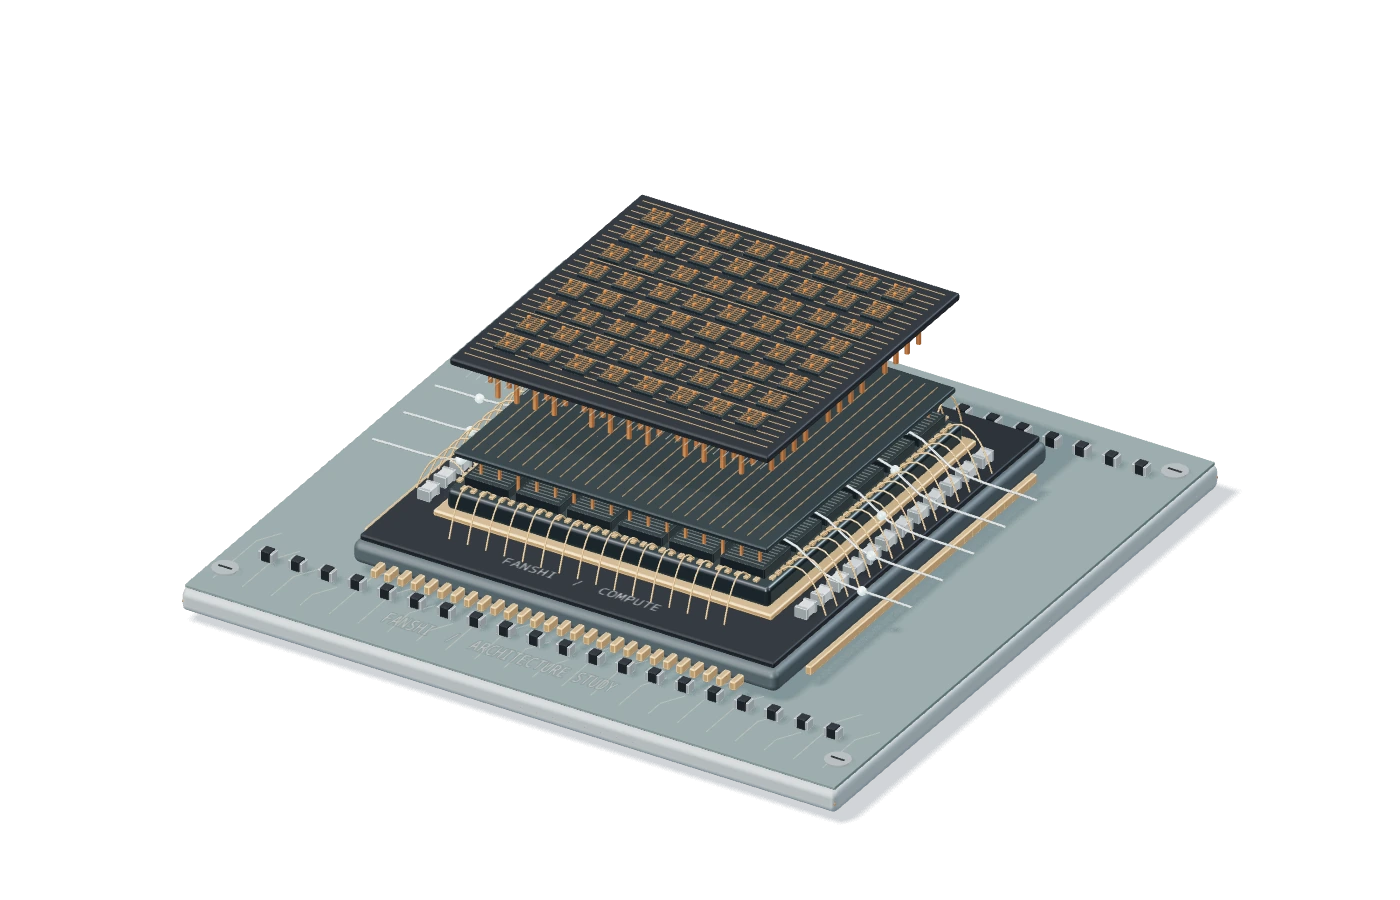
Внешний перенос весов на один токен
0MB
Что остаётся при работе
Вычисления на месте · без внешнего переноса весов
0.8B · оценка для INT8, не потребление системыРаздельная память
Каждый токен перемещает все веса
В обычном NPU или GPU память и вычислитель — отдельные кристаллы. При генерации каждого токена все веса проходят по шине: пропускная способность задаёт потолок, а большая часть энергии теряется в пути.
Вычисления в памяти
Поместить веса в массив памяти
Fanshi встраивает схемы умножения с накоплением прямо в массив памяти. Веса остаются в массиве, активации входят, результаты выходят. Весов на шине больше нет.
MaskROM
Записано при тейпауте, не перемещается при работе
Вычисления в памяти на масочном ПЗУ физически записывают веса в массив переходных отверстий при тейпауте. Чип выходит с фабрики уже с моделью внутри, поэтому энергопотребление и предельная стоимость инференса минимальны.
Одна цель,
три маршрута.
Все три переносят веса меньше или не переносят вовсе. Различие в том, где лежат веса и можно ли ещё менять модель. Первый вопрос, на который нужно ответить: как часто меняется ваша модель?
- Где лежат веса
- Слои масок, запись при тейпауте
- Перенос при работе
- Нет
- Обновление модели
- Фиксируется при тейпауте
- Подходит для
- Стабильные модели, большие тиражи, минимальные потребление и предельная стоимость
- Где лежат веса
- Внутри массива SRAM
- Перенос при работе
- Умножение с накоплением в массиве
- Обновление модели
- Загрузка при старте, можно обновлять
- Подходит для
- Модели среднего размера, устройства со сменой модели на месте
- Где лежат веса
- Внешняя память с высокой пропускной способностью
- Перенос при работе
- Потоковая обработка на кристалле
- Обновление модели
- Непрерывные итерации
- Подходит для
- Большие быстро меняющиеся модели, высоконагруженные узлы
Скорость декодирования на устройстве
Forge, проектная цель · Qwen 3.5 0.8B
Потребление системы
Forge, лёгкий класс
Данных остаётся на устройстве
Локальный инференс, сеть не нужна
Предельная стоимость инференса
После разовой покупки чипа
Что ещё почитать
 Что такое ИИ-чип с вычислениями в памяти? Три маршрутаИИ-чип с вычислениями в памяти выполняет умножение с накоплением внутри массива памяти, и веса больше не перемещаются. Чем различаются MaskROM, SRAM CIM и вычисления рядом с памятью.
 Вычисления в памяти на MaskROM: что значит записать веса в кремнийВычисления в памяти на MaskROM записывают веса модели в массив переходных отверстий на этапе масок, и при работе ничего не перемещается. Как это устроено, почему это дешевле всего и каковы ограничения.
 Стена памяти: почему LLM на устройстве буксуют и как её обойтиДекодирование LLM ограничено пропускной способностью: каждый токен читает все веса, и устройства не выдерживают такого потока. Насколько высока стена и как её преодолеть.
Выбрать маршрут для вашего проекта
Пришлите целевую модель, цели по производительности и потреблению и частоту изменения модели. Мы ответим с предложением маршрута и планом оценки.