

現成的晶片,和一條為你定製的路。
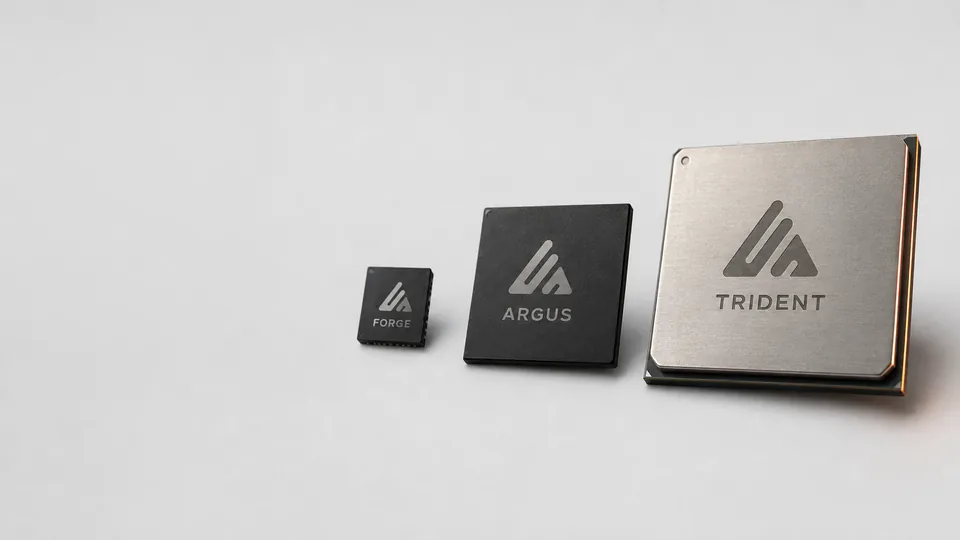
第一代量產 ASIC 覆蓋輕量語言模型、重載推理與多模態視覺;同一套核心與路線,也可以為你的模型定製一顆。


Qwen3.5 → 3.6 → 3.8
新模型,不用重新設計架構。
Qwen3.6 與 Qwen3.8 沿用 Qwen3.5 的混合架構,燔石現有推理核心可以直接對映。同一家族的新模型是一次新的晶片構建,而不是重新設計。
從一封郵件到一顆晶片
01
確認路線
目標模型、效能與功耗目標、更新頻率、介面需求。第一個問題永遠是:模型多久變一次。
02
FPGA 評估
在評估板上部署推理核心,跑通模型,測量精度與吞吐,形成第一臺工程樣機。
03
系統匯入
圍繞評估結果做介面、系統軟體與現場驗證,把樣機變成產品原型。
04
ASIC 交付
模型凍結後,採用量產 ASIC,或把 IP 整合進客戶自己的晶片投片。
延伸閱讀
 Model-on-Chip 是什麼?把大模型固化進晶片的專用 ASIC:雲端與端側Model-on-Chip(模型固化晶片、模型專用 ASIC)把某一個大模型的權重直接做進矽晶片,換來數量級的速度與能效。原理、Taalas HC1 證明了什麼、雲端與端側的區別,以及評估供應商時該問的問題。
 端側推理晶片怎麼選:從模型、功耗到更新方式的七個問題為裝置選端側推理晶片時,真正決定成敗的不是峰值算力,而是模型是否放得下、功耗是否撐得住、模型能不能更新。本文給出七個必須先回答的問題和一張選型清單。
 推理算力成本怎麼算:API、自建 GPU 與買斷式晶片的三年賬推理算力的賬要按三年算:API 按 token 計費、自建 GPU 按卡時攤銷、專用晶片一次買斷。本文給出三種方式的計算口徑、一個可復算的例子,以及回本週期的估算方法。
申請 ASIC 工程樣機
把目標模型、效能目標、功耗範圍和介面需求發給我們,確認適配路徑後回覆樣機方案。